Векторная база данных — это специальная система для хранения, индексации и быстрого поиска информации в виде многомерных векторов (эмбеддингов). Главная ее особенность — находить похожие объекты по смыслу (семантике), а не по точному совпадению слов или цифр. Такие системы позволяют проводить расширенный анализ данных и поиск по сходству, выходя за рамки традиционных подходов к структурированным запросам, характерных для обычных СУБД.
Почему стоит использовать векторную базу данных?
Объём данных постоянно растёт. В настоящее время мы имеем дело с огромным количеством неструктурированных данных, таких как изображения, текст и аудио, которые невозможно организовать в привычные структурированные таблицы. Тем не менее, необходима возможность легко извлекать пользу из этого ежедневного потока данных — объёмом почти в 330 миллионов терабайт.
Традиционные базы данных, даже с расширениями, добавляющими некоторые возможности обработки векторов, испытывают сложности с обработкой специфики и требований, предъявляемых к многомерным векторным данным.
Обработка векторных данных крайне ресурсоёмка. Один стандартный вектор занимает около 6 КБ памяти. Очевидно, масштабирование до миллионов векторов потребует значительных объёмов системной оперативной памяти и вычислительных ресурсов, и это является серьёзной проблемой для традиционных баз данных OLTP и OLAP.
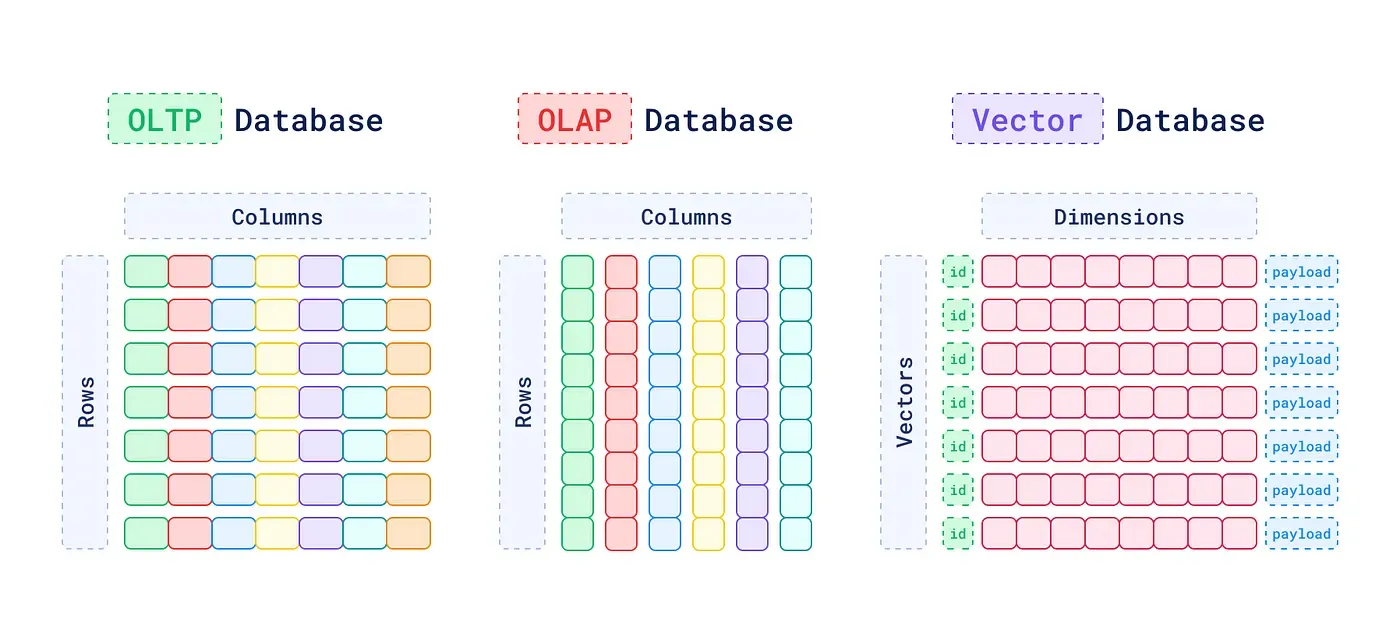
Векторные базы данных позволяют учитывать контекст или семантическое сходство неструктурированных данных, представляя их в виде векторов. Это обеспечивает возможность проведения углублённого анализа и поиска на основе близости данных.
Например, в рекомендательных системах векторные БД могут анализировать поведение пользователей и характеристики товаров, чтобы предлагать продукты или контент с высокой степенью персональной релевантности.
В поисковых системах и исследовательских хранилищах они улучшают пользовательский опыт, предоставляя результаты, семантически схожие с поисковым запросом. При этом система не полагается исключительно на точное совпадение слов, введённых в строку поиска.
Если вы только знакомитесь с областью векторного поиска, данная статья объясняет ключевые понятия и взаимосвязи, необходимые для работы.
Итак, приступим.
Что такое векторные данные?
Чтобы понять суть векторных баз данных, начнём с определения «вектора» или «векторных данных».
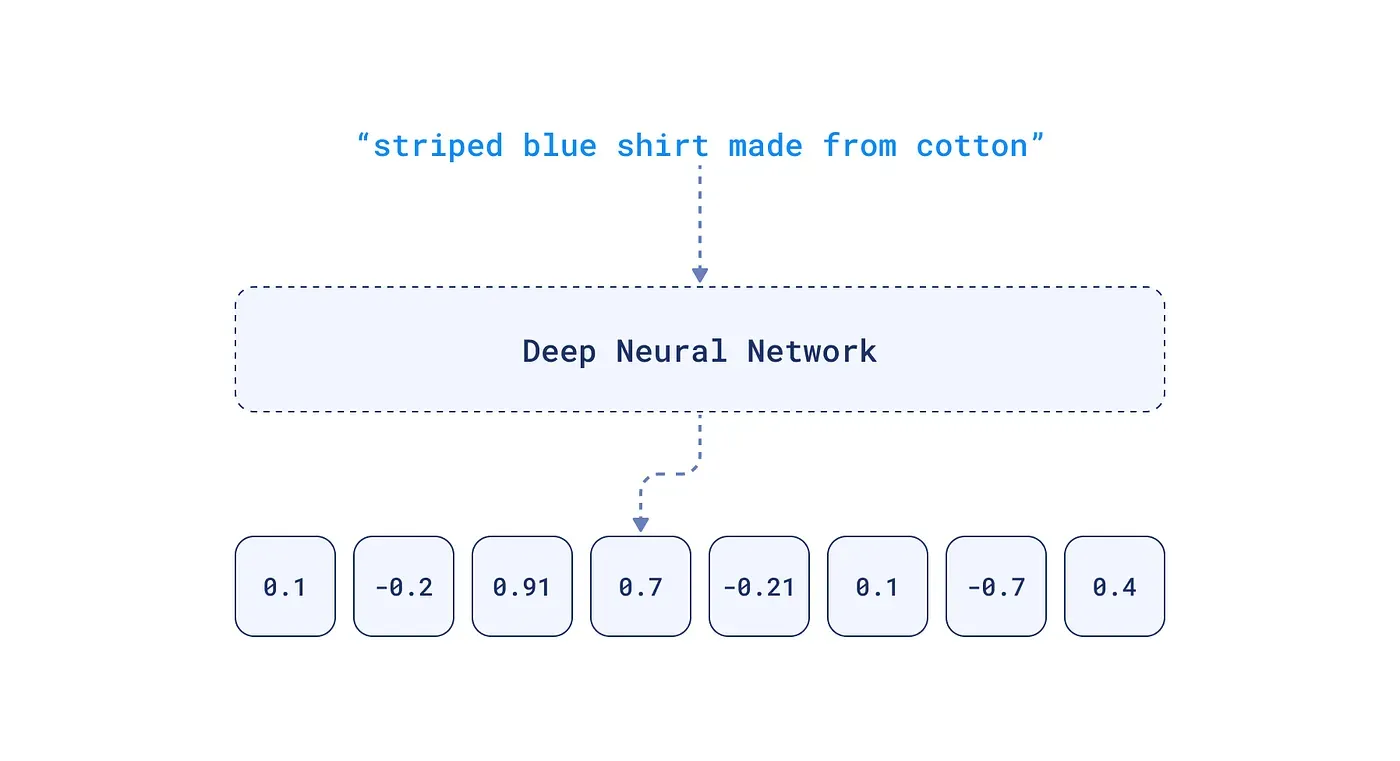
Вектор — это упорядоченный массив чисел, который кодирует смысл неструктурированного объекта, такого как текст, картинка или звук. Близкие по значению объекты имеют похожие наборы чисел и находятся рядом друг с другом в многомерном пространстве.
Например, при представлении текстовых данных учитываются языковые нюансы, такие как семантика и контекст.
В случае с изображением векторные данные описывают такие аспекты, как цвет, текстура и форма. Размеры отражают сложность и объём информации, заложенной в каждом изображении. Каждый пиксель можно рассматривать как одномерную единицу данных, поскольку он содержит информацию (например, значения интенсивности цвета для красного, зелёного и синего каналов). Таким образом, даже небольшое изображение из тысяч пикселей преобразуется в тысячи измерений.
Когда мы говорим о многомерных данных, мы подразумеваем данные, содержащие большое количество признаков (пикселей, характеристик, семантических и синтаксических элементов).
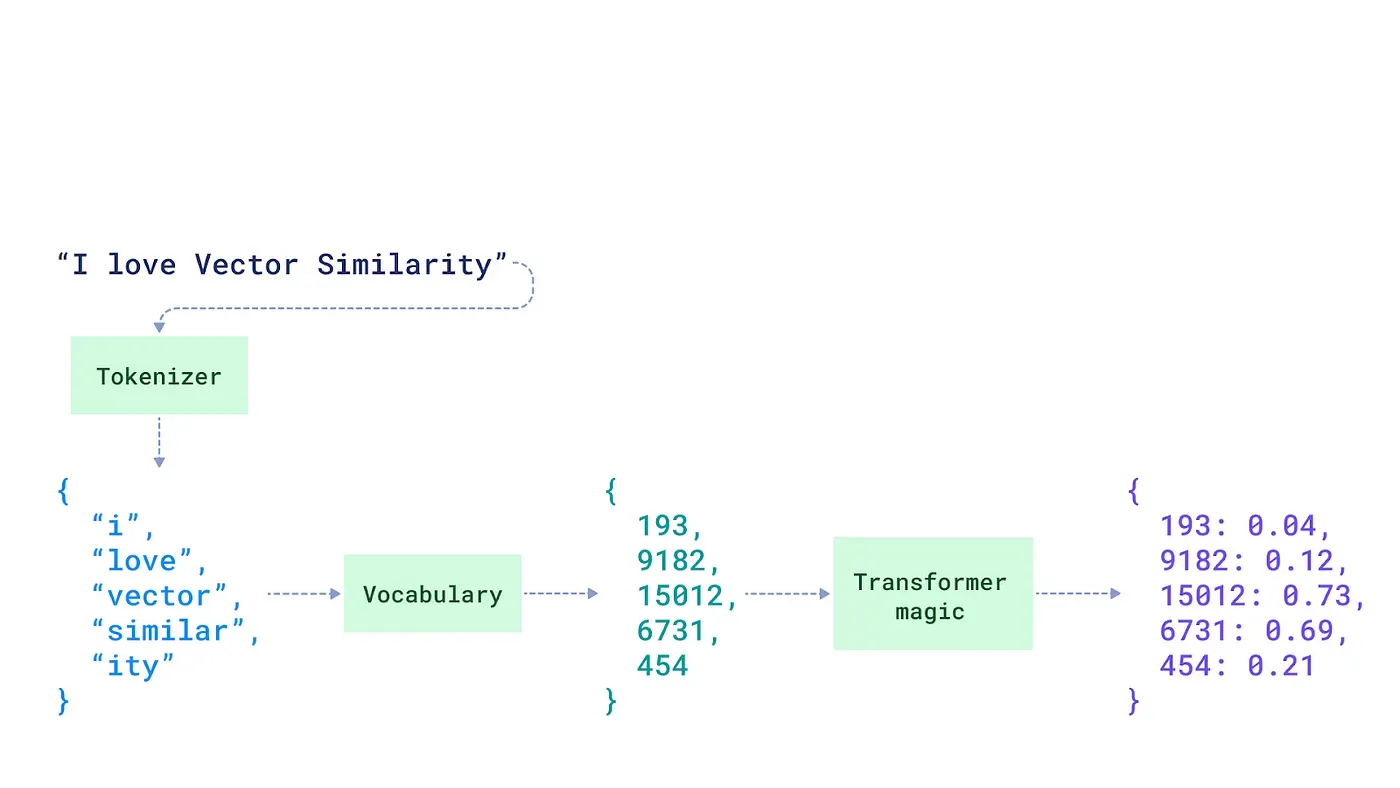
Создание векторных данных для их последующего хранения в векторной базе данных осуществляется преимущественно с помощью эмбеддингов (встраиваний).
Как работают эмбеддинги?
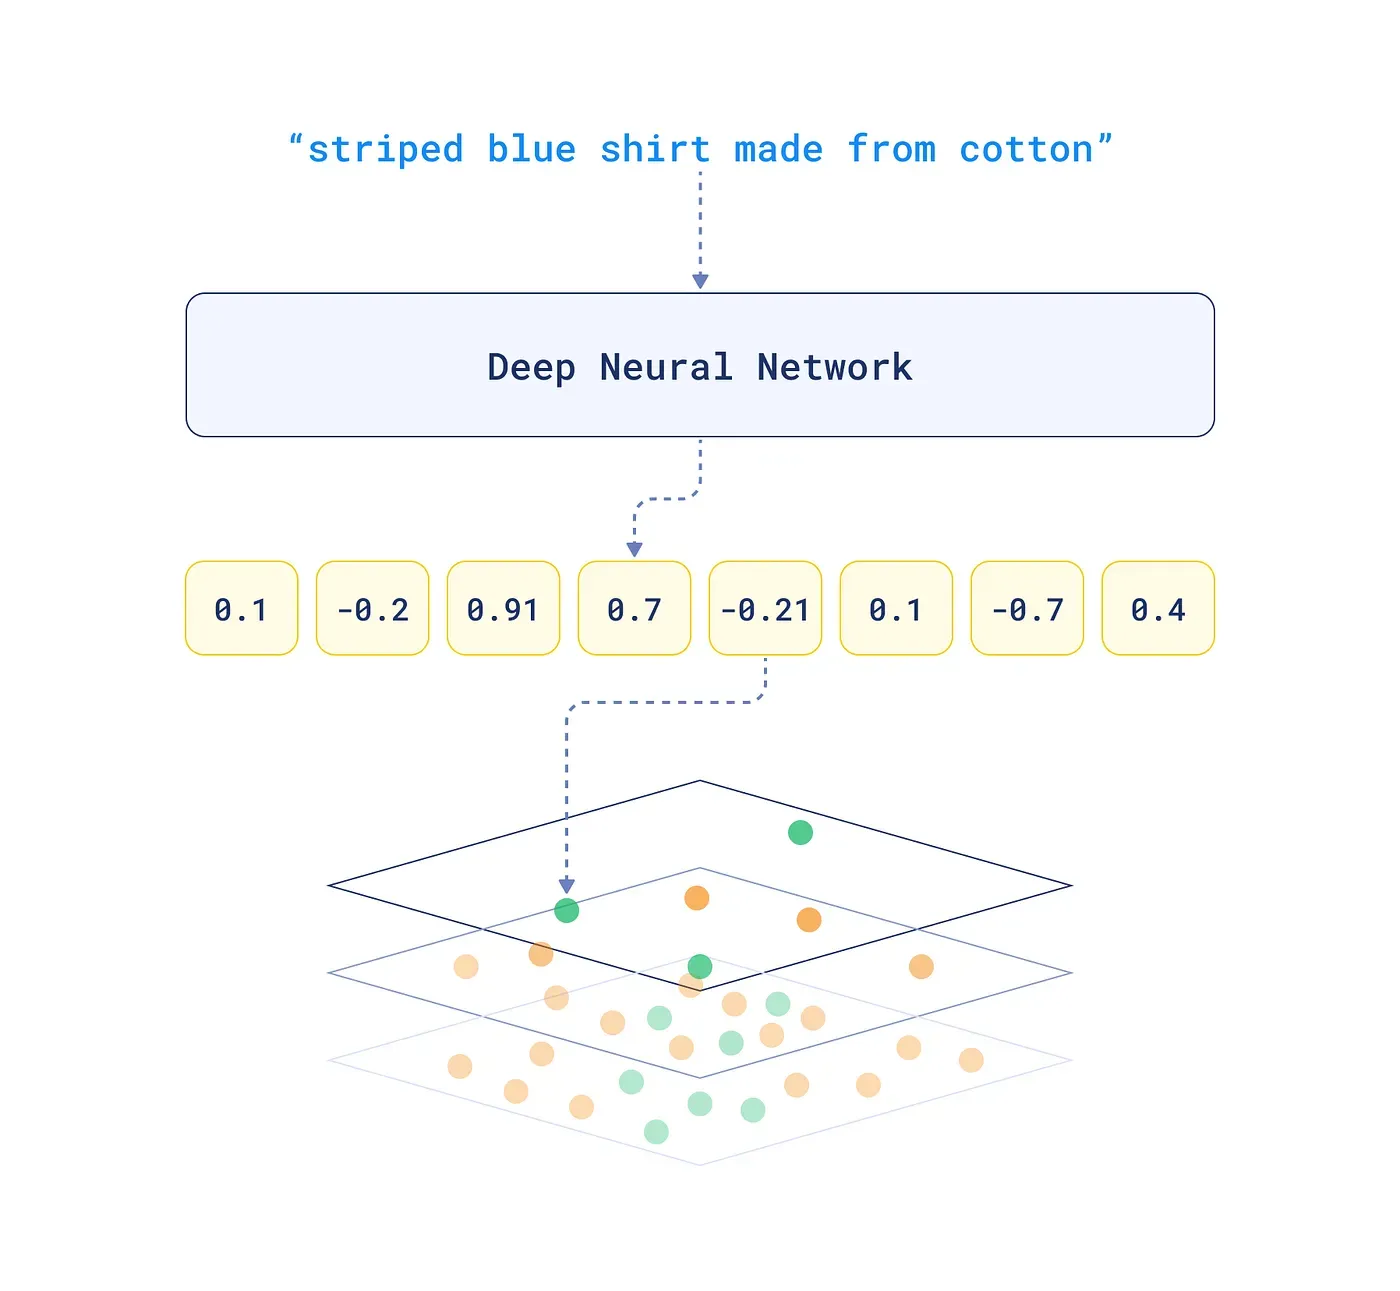
Эмбеддинги преобразуют многомерные данные в более удобную низкоразмерную векторную форму, которая лучше подходит для приложений машинного обучения и обработки данных. Обычно этот процесс выполняется с помощью моделей нейронных сетей.
Например, при создании представлений для текста процесс включает анализ текста для выделения его лингвистических элементов.
Для создания векторных представлений текста широко используются трансформерные модели (или трансформерные энкодеры), такие как BERT (Bidirectional Encoder Representations from Transformers) и GPT (Generative Pre-trained Transformer).
Каждый слой сети извлекает признаки различного уровня: от контекста и семантики до синтаксиса.
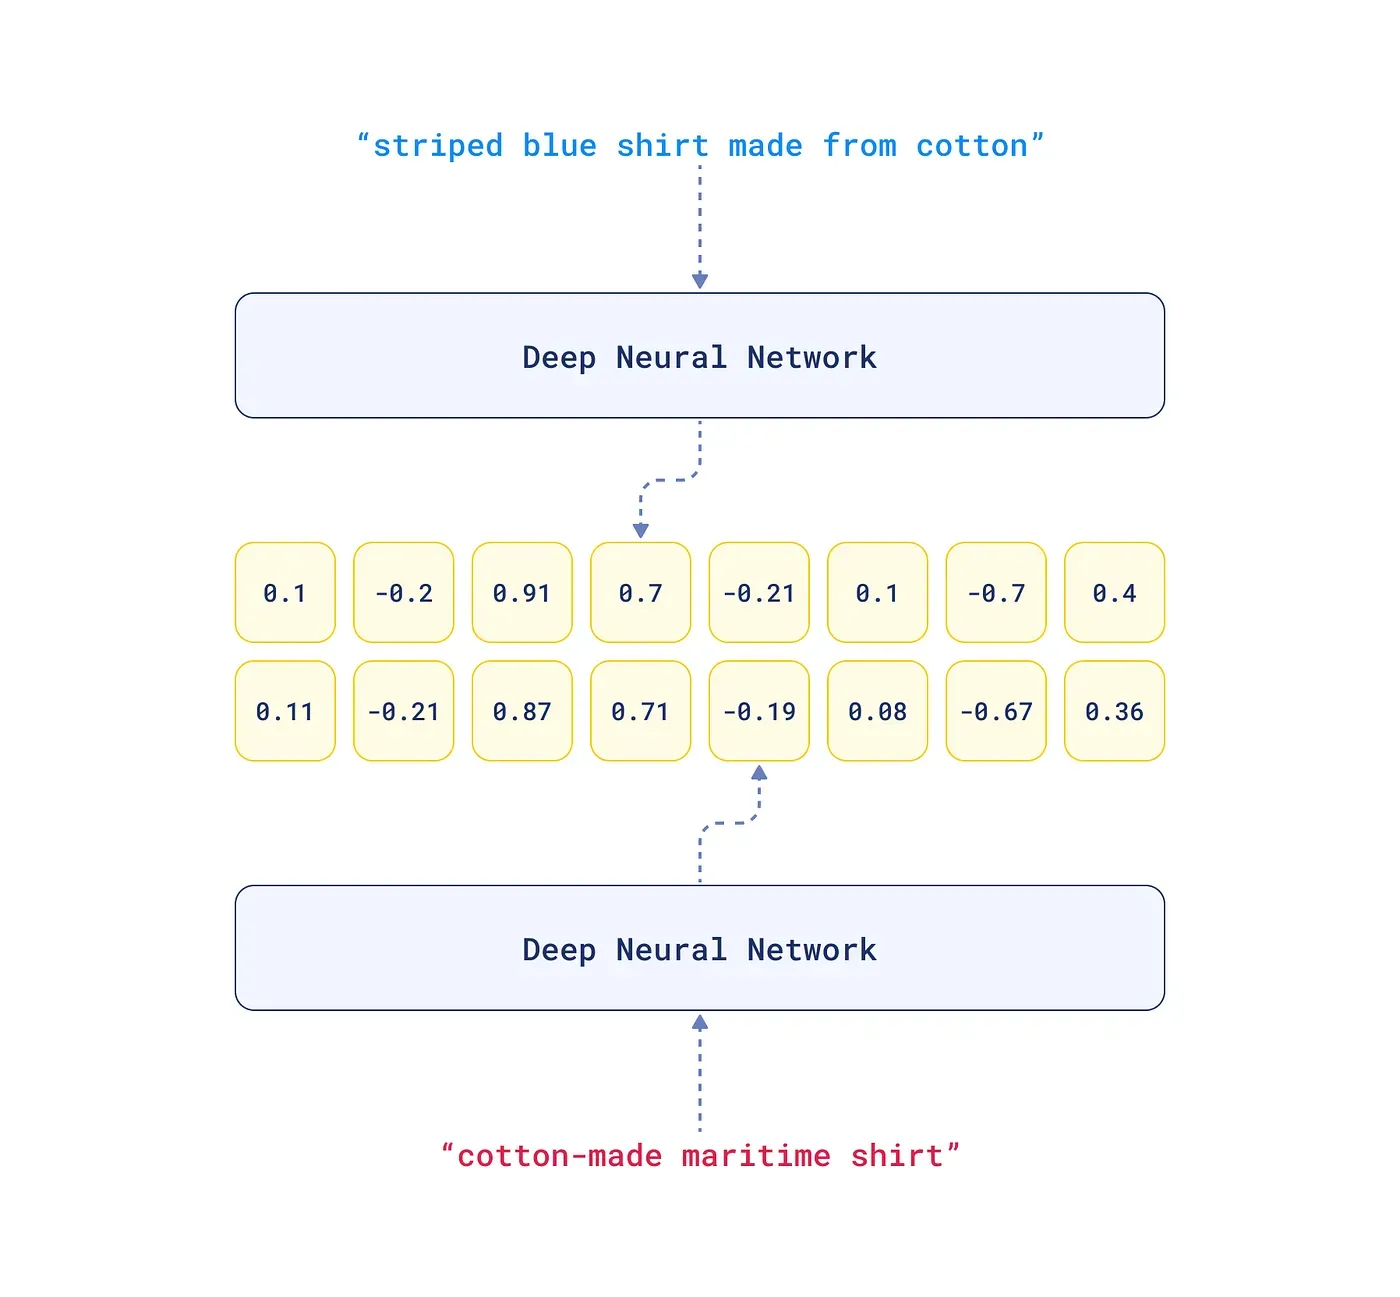
Заключительные слои сети сжимают эту информацию в единый вектор. Это компактное, низкоразмерное представление сохраняет основную смысловую нагрузку оригинальных данных.
Основные функциональные возможности векторных баз данных
Что такое индексирование?
Вы когда-нибудь пытались найти конкретного человека на фотографии огромной толпы? Векторным базам данных приходится решать аналогичную задачу при работе с множеством многомерных векторов.
Представьте, что вы группируете людей сначала по цвету волос, затем по цвету глаз, а потом по стилю одежды. Каждый шаг приближает вас к нужному объекту. Векторные БД используют похожие многоуровневые структуры, называемые индексами, для организации векторов на основе их «близости».
Благодаря этому поиск похожих объектов становится быстрым процессом навигации по связанным кластерам, без необходимости проверять каждый элемент отдельно.
Существуют различные методы индексации, каждый из которых оптимизирован под свои задачи. Алгоритм HNSW обеспечивает баланс между скоростью и точностью. Другие методы, такие как IVF (Inverted File Index) или Product Quantization, ориентированы на выполнение конкретных сценариев или повышение эффективности использования памяти.
Что такое бинарное квантование?
Квантование — метод снижения общего размера базы данных. Он работает за счёт сжатия векторов в более компактное представление ценой частичного снижения точности.
Бинарное квантование — быстрый метод индексации и сжатия данных, активно применяемый в Qdrant. Он поддерживает прямое сравнение векторов, что может ускорить обработку запросов вплоть до 40 раз.
Принцип можно объяснить так: каждая точка данных условно делится пороговым значением. Все величины выше порога фиксируются как 1, ниже — как 0. В результате получается битовая последовательность, представляющая исходный вектор.
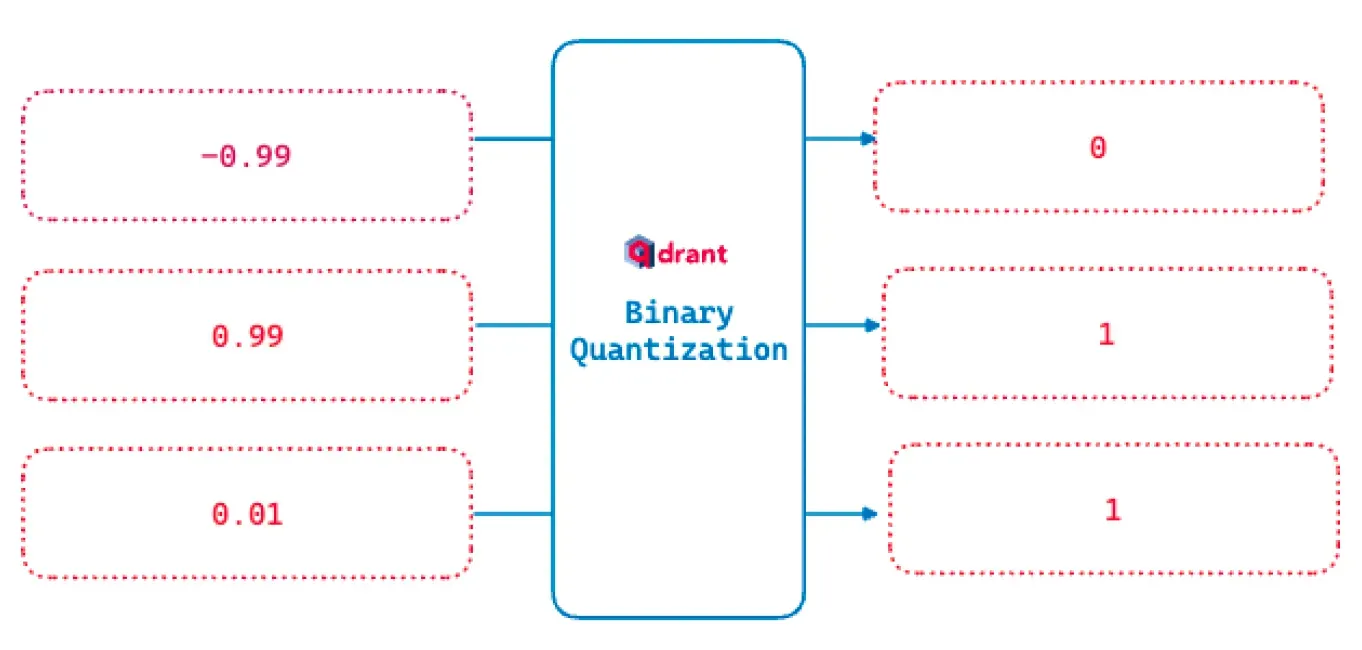
Такой «квантованный» код значительно меньше по объёму и проще в сравнении. Для эмбеддингов от OpenAI этот тип квантования показал высокую эффективность, обеспечивая существенный рост производительности при минимальной потере точности.
Что такое поиск по сходству?
Поиск по сходству позволяет искать объекты не по ключевым словам, а по смыслу. Это даёт возможность находить похожие музыкальные треки с одинаковым настроением, изображения, соответствующие вашему запросу, или выявлять эмоциональные паттерны в тексте.
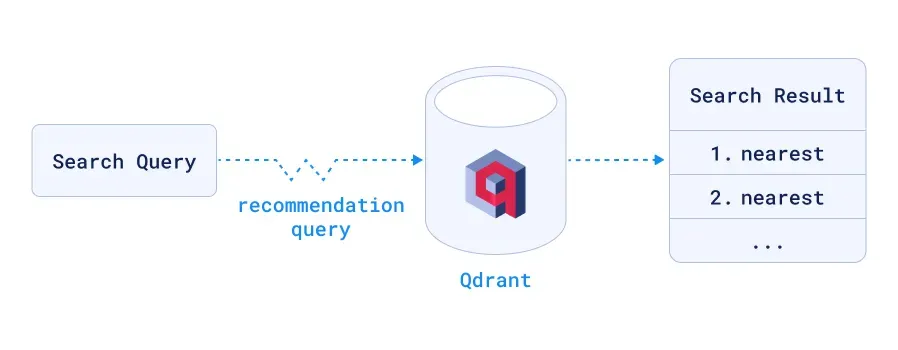
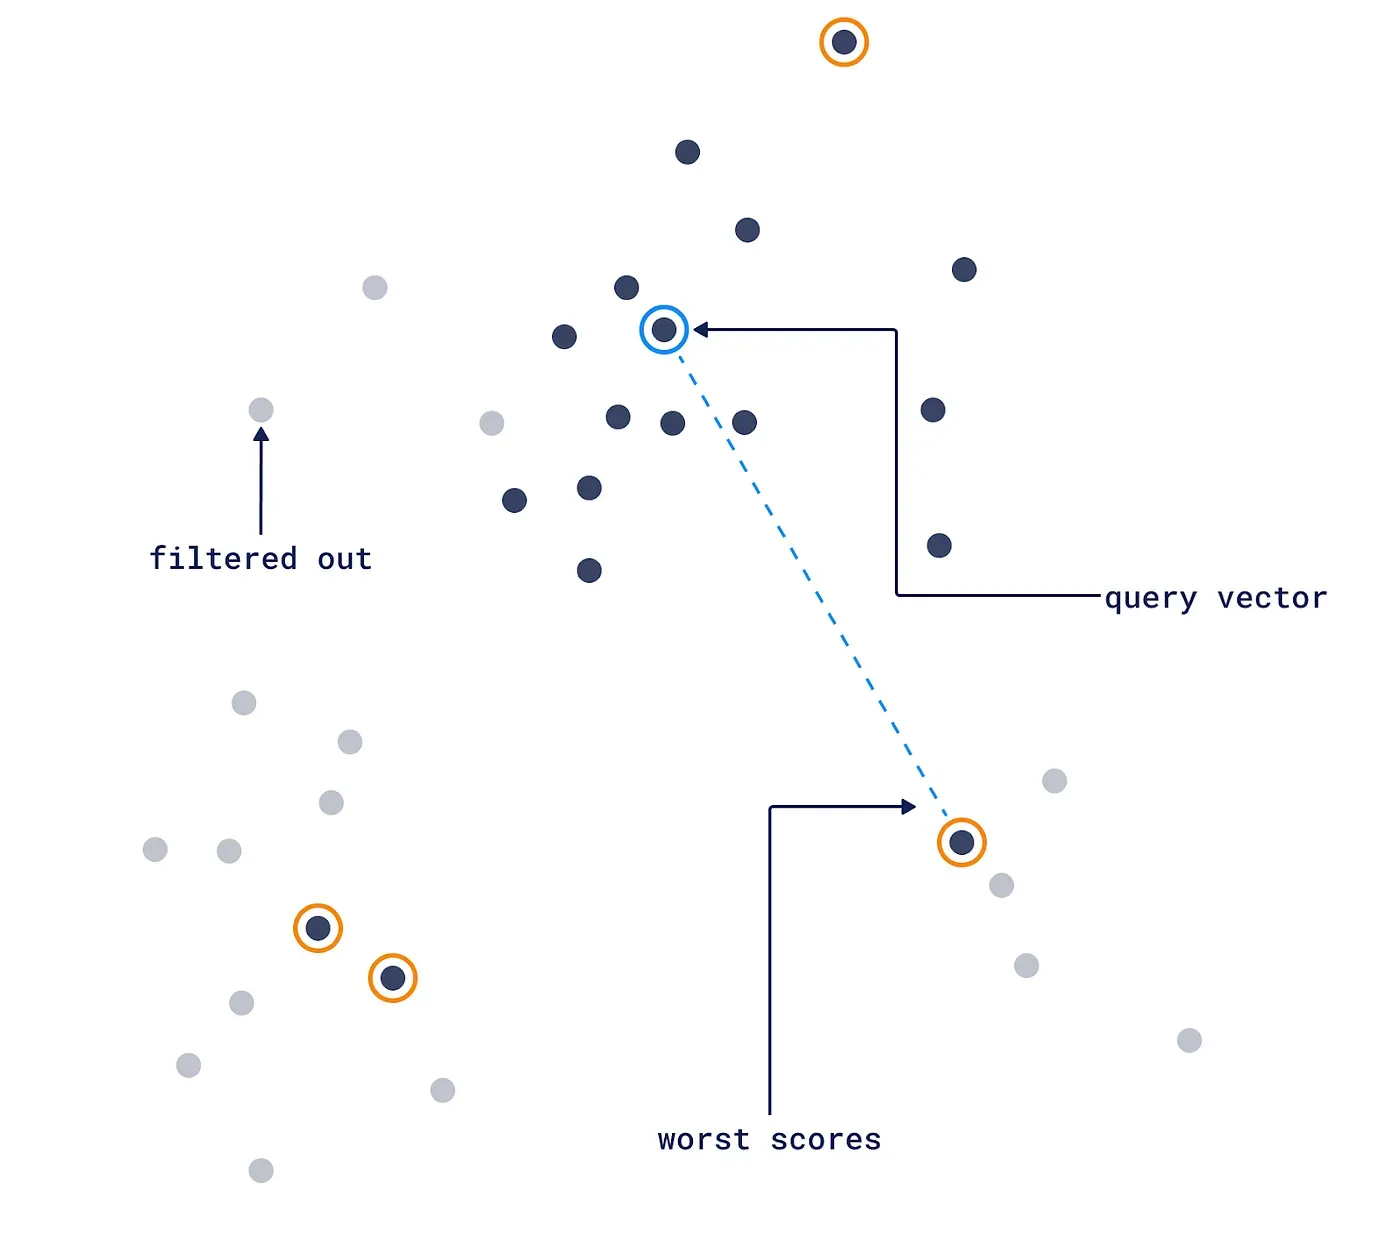
Принцип работы строится так: когда пользователь отправляет запрос, сама эта фраза также преобразуется в вектор (вектор запроса). Поиск начинается с верхнего уровня индекса HNSW, где алгоритм быстро определяет область графа, наиболее вероятную для нахождения ближайших соседей. Далее алгоритм сравнивает вектор запроса с остальными элементами, используя метрики расстояния или сходства, чтобы оценить степень близости.
Затем поиск постепенно сужается до наиболее тесно связанных векторов. Цель — отфильтровать набор данных до максимально релевантных элементов. После нахождения ближайших точек на нижнем уровне индекса они преобразуются обратно в исходные объекты: изображения, документы или аудиозаписи, которые возвращаются пользователю.
Масштабируемость
Векторные базы данных часто оперируют наборами данных, содержащими миллиарды многомерных векторов. Эти массивы не только велики по объёму, но и требуют значительных вычислительных мощностей и памяти. Масштабируемые системы справляются с этой нагрузкой без деградации производительности. Это достигается за счёт распределённой архитектуры, динамического распределения ресурсов, шардирования (разделения данных), балансировки нагрузки и специализированных методов оптимизации.
Решения вроде Qdrant демонстрируют горизонтальную масштабируемость. Использование языка Rust обеспечивает предсказуемое управление памятью и высокую производительность, позволяя эффективно обрабатывать крупные объёмы данных при оптимальном потреблении ресурсов.
Эффективная обработка запросов
Ключ к быстрой обработке запросов заложен в методах индексирования, которые обеспечивают быструю навигацию по сложным многомерным структурам. Благодаря работе в пространстве векторов, HNSW и аналогичные индексы радикально сокращают время, необходимое для поиска и извлечения релевантной информации.
Для повышения пропускной способности, особенно при обработке множества одновременных запросов, применяются управление вычислительной нагрузкой и параллельная обработка. Дополнительно используется стратегическое кэширование часто запрашиваемых блоков данных, что ускоряет отдачу результатов при повторных обращениях.
Фильтры позволяют уточнять поиск с помощью метаданных. Например, в коллекции текстовых документов можно искать не только по семантической близости, но и фильтровать результаты по дате публикации, автору или категории.
При выполнении запроса система использует одновременно векторные данные и метаданные. База данных ищет ближайшие векторы строго в рамках дополнительных условий, заданных фильтрами, что позволяет строить гибкие и персонализированные сценарии выдачи.
Безопасность данных и контроль доступа
Векторные БД часто хранят конфиденциальную информацию: персональные данные клиентов, закрытые медиафайлы или служебные документы. Обеспечение безопасности подразумевает защиту этих данных от несанкционированного доступа, утечек и иных киберугроз.
В архитектуре Qdrant для этого реализованы следующие механизмы:
-
Аутентификация пользователей и сервисов
-
Управление доступом на основе ролей (RBAC)
-
Управление доступом на основе атрибутов (ABAC)
-
Шифрование данных в состоянии покоя (at rest) и при передаче (in transit)
-
Ведение журналов аудита
-
Расширенный мониторинг состояния БД и автоматическое обнаружение аномалий
Архитектура векторной базы данных
Векторная база данных состоит из нескольких ключевых компонентов. Ниже приведены основные термины Qdrant и их назначение:
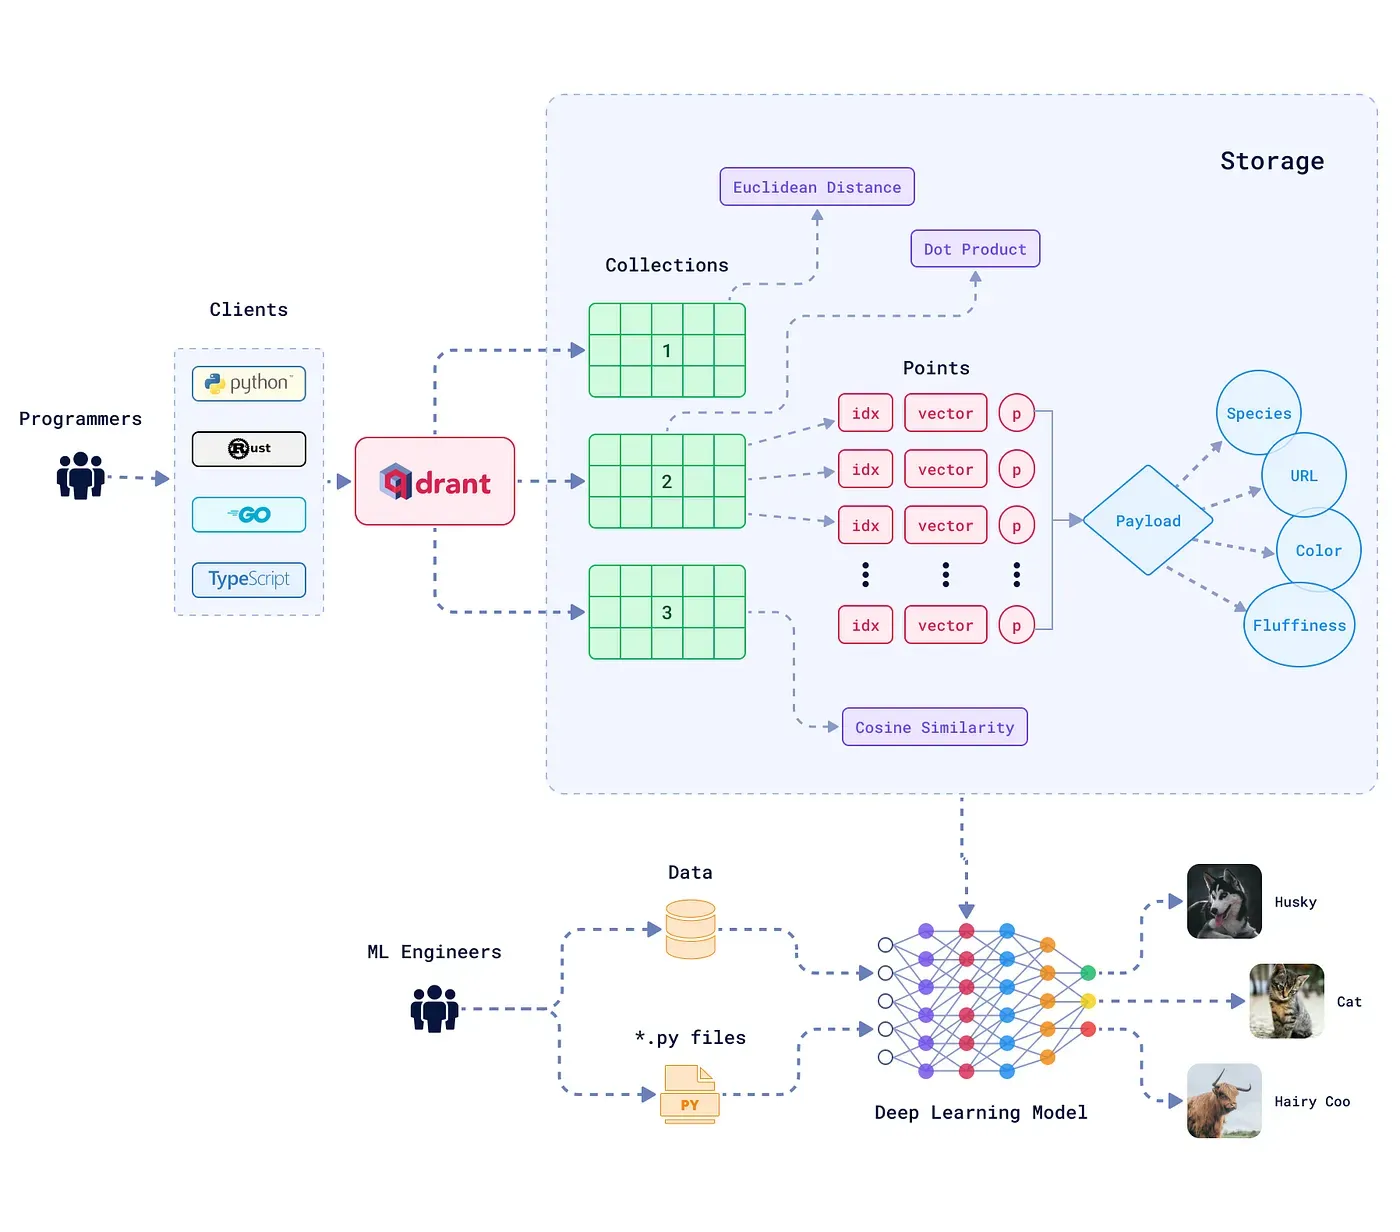
Коллекции — именованные контейнеры для точек данных. Каждая точка внутри коллекции — это вектор со связанной полезной нагрузкой. Все векторы в одной коллекции должны иметь одинаковую размерность и быть сопоставимы через единую выбранную метрику.
Метрики расстояния — математические функции, измеряющие степень схожести между векторами. Выбор метрики происходит при создании коллекции и зависит от природы данных и модели, генерирующей векторы.
Точки (Points) — базовая единица хранения. Содержит вектор, необязательный уникальный идентификатор (ID) и полезную нагрузку (payload). Полезная нагрузка добавляет контекст или дополнительные атрибуты к сырым векторным данным.
Payload (полезная нагрузка) в векторных базах данных — это набор дополнительных пользовательских метаданных (в формате JSON), которые жестко привязаны к конкретному вектору. Он хранит исходный текст, ссылки, категории или параметры объекта, позволяя фильтровать результаты поиска по смыслу вместе с точными условиями
Варианты хранения:
- Режим в оперативной памяти (
RAM): все векторы размещаются в ОЗУ для максимальной скорости чтения. На диск сохраняются только структурные данные и журналы для восстановления. - Режим
Memmap: создаётся виртуальное адресное пространство, привязанное к файлу на диске. Обеспечивает оптимальный баланс между экономией оперативной памяти и скоростью доступа.
Клиенты — Qdrant предоставляет официальные библиотеки взаимодействия для различных языков программирования, включая Python, Go, Rust и TypeScript. Разработчики могут интегрировать векторный поиск в проект, используя привычный стек технологий.
Примеры использования векторных баз данных
Если попытаться сформулировать все варианты применения векторных БД одним словом, это будет сопоставление. Система отлично справляется с поиском неявных связей между данными и заданным запросом: будь то визуальная схожесть картинок, смысловое родство текстов, паттерны поведения пользователей или корреляции в аналитике.
Типовые сценарии использования векторных БД:
Персонализированные рекомендательные системы анализируют сложные пользовательские данные: историю взаимодействий, предпочтения и временные паттерны. Например, стриминговые сервисы учитывают циклическое прослушивание определённых треков или частоту пропусков для формирования индивидуальной ленты.
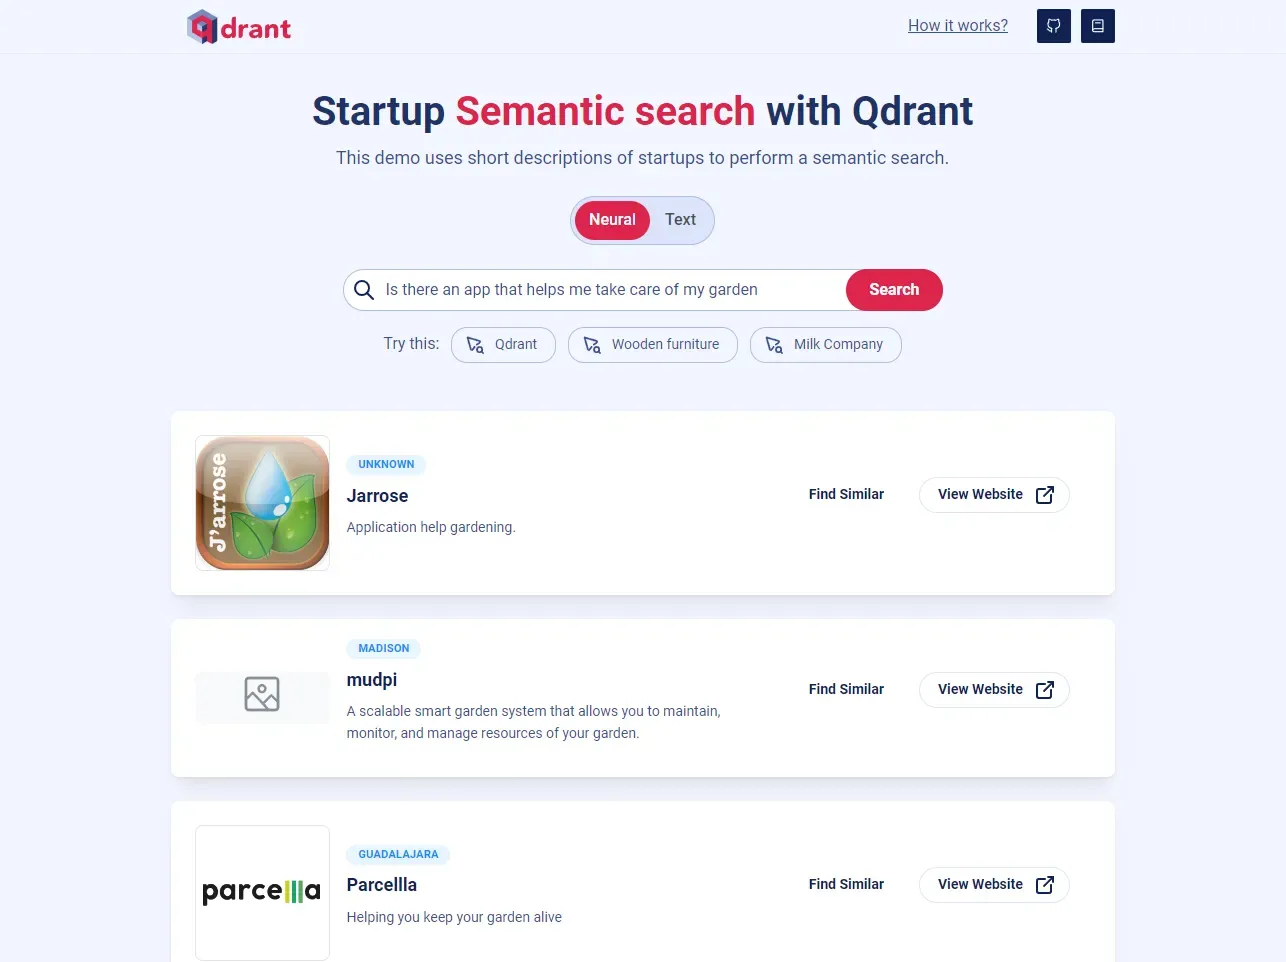
Семантический поиск наделяет системы способностью улавливать глубинный смысл фраз. При запросе «советы по посадке весной» современная система попытается понять интенцию и контекст, вернув материалы по весне, почвам и агротехнике, даже если точных совпадений в заголовках нет. Вот пример векторной поисковой системы для стартапов, созданной с помощью Qdrant:
Помимо этого, векторные БД активно применяются в обнаружении мошенничества и анализе аномалий (финтех, кибербезопасность) для выявления отклонений от нормального профиля поведения. Также реализуется поиск изображений по содержимому (CBIR) путём прямого сравнения векторных репрезентаций, что исключает зависимость от ручной разметки или тегов.
Это лишь часть практических кейсов. Универсальная способность векторных хранилищ эффективно сопоставлять данные делает их критически важным компонентом современных AI-приложений.
Запуск Qdrant на платформе Dockhost
Вы можете легко начать эксперименты с векторной базой Qdrant без сложных настроек серверов на платформе Dockhost. Просто найдите готовое приложение в нашем каталоге, нажмите кнопку установки и за несколько минут получите полностью рабочую self-hosted СУБД. Она будет готова к подключению в ваших проектах ещё до написания первого запроса. Вы также можете запустить рядом основное приложение, дополнительные микросервисы или клиентскую часть, все в едином аккаунте в рамках одного проекта. Так вы быстро соберёте единую рабочую среду для любых задач — от семантического поиска до персональных рекомендаций — без лишних затрат времени.