Блог - Dockhost

Практические материалы по DevOps, контейнеризации и управлению облачной инфраструктурой. Пошаговые руководства и экспертные статьи, которые помогут вам оптимизировать деплой и ускорить работу приложений.

  • MinIO больше не поддерживается: лучшие альтернативы S3-совместимого хранилища

    В апреле 2026 года GitHub-репозиторий MinIO архивировали, а образы minio/minio и minio/mc исчезли с Docker Hub. Работающие кластеры никуда не делись, но новые развёртывания и обновления образов стали проблемой — командам с self-hosted S3 пора выбирать альтернативы MinIO. В статье разбираем, чем заменить MinIO: три S3-совместимых объектных хранилища — Garage, RustFS и SeaweedFS. Garage силён в географически распределённых и мультисайтовых развёртываниях, RustFS ближе всего к привычной модели MinIO, а SeaweedFS закрывает сценарии, где кроме S3 нужны файловый доступ, HDFS и работа с большим числом мелких объектов. В помощь — сравнительная таблица по 15 критериям: язык, архитектура, erasure coding, сложность миграции и эксплуатации. Далее
  • PaaS в России 2026: как меняется рынок и как выбирать платформу для продуктовой команды

    В 2024–2025 годах рынок управляемых платформ для запуска приложений, сервисов и проектов в России прошёл стадию активного тестирования и формирования базовых механизмов обеспечения доступности. К 2026 году инфраструктурные решения данного класса перешли из категории экспериментальных инструментов в стандарт промышленной разработки. В материале рассматривается текущая структура рынка, критерии устойчивости платформ и технологические тренды, определяющие выбор среды для продуктовых команд. Далее

  • GLM 5.3: бенчмарки, обзор и реакция ИИ-сообщества — что стоит за цифрами

    Обзор GLM 5.3 от Z.ai: вся прибавка качества получена пост-тренингом на прежней базе GLM 5.2, без новой архитектуры. Разбираем бенчмарки: рост в шесть раз на Terminal-Bench 3.0 (28.3 против 4.6), первое место на CyberGym (84.5%) — и отставание от закрытых флагманов в эксплуатации уязвимостей. Плюс главные обсуждаемые темы релиза — тревога Грега Брокмана об «ускорении ландшафта угроз» — и вердикт тестеров по цене: GLM 5.3 примерно в 11 раз дешевле Fable 5 и в 7 раз дешевле GPT-5.6 Sol Далее

  • ИИ-агенты за 5 минут: как работает фреймворк ReAct и почему обычные чат-боты устаревают

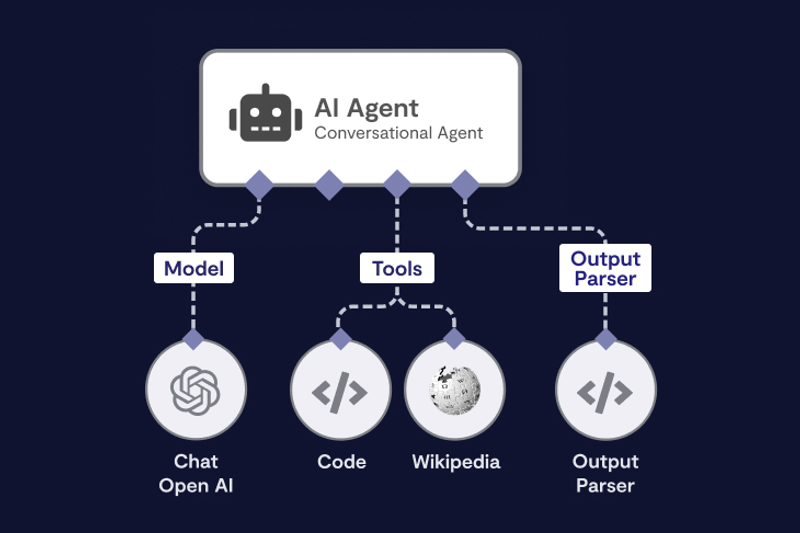
    Обычные нейросети часто выдумывают факты при нехватке свежей информации, но ИИ-агенты решают эту проблему с помощью цикла ReAct. В этой статье мы простыми словами объясняем, как модели получают возможность самостоятельно обращаться к веб-поиску и базам данных для выполнения реальных задач. Читайте материал, чтобы на наглядных примерах понять базовую механику работы ИИ агентов и узнать, почему эра простых чат-ботов подходит к концу. Далее

  • LLM простыми словами: 5 ключевых терминов искусственного интеллекта, которые нужно знать каждому

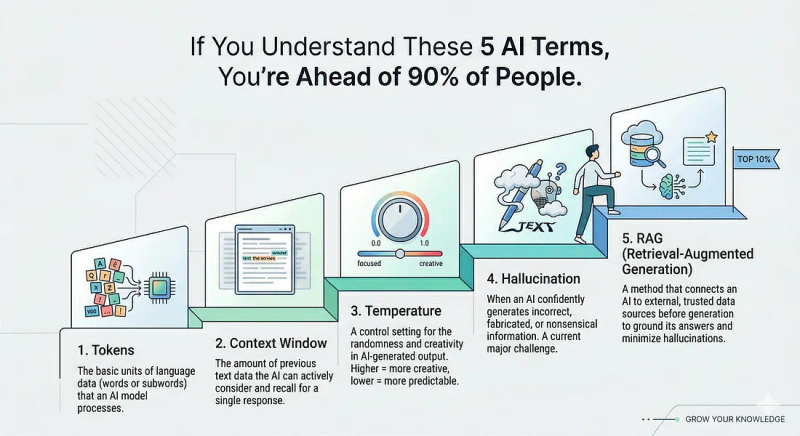
    Основные блоки, из которых состоит LLM. Разбираем 5 реальных механизмов работы больших языковых моделей: от природы токенов до архитектуры RAG. Узнаете, почему модель „теряет нить“, как менять её точность одной настройкой и почему она так уверенно придумывает факты. Чёткая база для тех, кто хочет управлять ИИ-продуктами осознанно, а не кликать по кнопкам вслепую. Далее

  • Свой приватный ChatGPT за 5 минут: Open WebUI и пул нейросетей с оплатой в рублях

    Как сделать свой приватный ChatGPT для команды без VPN и зарубежных карт? В материале разбираем, как развернуть Open WebUI за 5 минут и подключить пул нейросетей с оплатой в рублях. Показываем, как настроить RAG для работы с внутренними документами и не допустить галлюцинаций. Считаем реальную экономию бюджета для IT-команды и объясняем, где физически хранятся ваши данные. Далее

  • Qwen 3.8: агентный кодинг уровня Opus на локальном ИИ

    Qwen 3.8-27B — открытая локальная модель, которая впервые всерьёз претендует на роль кодинг-агента уровня Opus на потребительском железе. При квантовании Q4 веса занимают всего 15,7–17,9 ГБ, поэтому модель реально запустить на RTX 3090 или RTX 4090 с 24 ГБ видеопамяти. По заявленным бенчмаркам новинка набирает 73,0 на Terminal Bench 2.1 и 61,7 на SWE-bench Pro, заметно опережая предшественницу, а лицензия Apache 2.0 делает её полностью свободной для коммерческого использования. Далее

  • Dockerhosting и Dockhost: техническое сравнение платформ для хостинга контейнеров

    В материале представлено детальное техническое сравнение платформ для хостинга контейнеров Dockerhosting и Dockhost. Мы разбираем архитектурные различия между классическим хостингом и универсальным PaaS, включая организацию мультисервисных проектов и сетевое взаимодействие. Рассматриваем возможности платформ в части деплоя (автодеплой из Git), наличие каталога готовых приложений и встроенного LLM API с рублевой оплатой. Анализ моделей тарификации и инструментов для командной работы поможет разработчикам и техническим руководителям выбрать решение, соответствующее задачам проекта. Далее

  • Как создать своего ИИ-агента в n8n: пошаговое руководство для начинающих и не только

    Автоматизация с помощью ИИ-агентов давно перестала быть уделом только разработчиков и стала доступна каждому. Платформа n8n позволяет визуально собирать сложные сценарии, подключать любые языковые модели и интегрировать сотни сервисов для автономной обработки данных и генерации контента. В этом руководстве мы подробно разберем, как быстро развернуть n8n и подключить к ней нейросети. Вы узнаете, как создать AI-агента, настроить его память и инструменты для решения реальных бизнес-задач. Материал подойдет как новичкам, так и опытным специалистам, которым важен полный контроль над логикой работы интеллектуальных систем. Далее

  • Агрегатор нейросетей: для чего он нужен и как выбрать оптимальный в России

    Если вы разрабатываете веб-сервис, мобильное приложение или SaaS-продукт с поддержкой ИИ, и используете в своем проекте более одной LLM модели, то рано или поздно столкнётесь с двумя системными ограничениями: необходимость оплачивать доступ к моделям в валюте и управление множеством разных API-ключей и подписок. Эту задачу отлично решает агрегатор нейросетей. Вы получаете доступ к десяткам LLM-моделей через один аккаунт, оплачиваете рублями и переключаетесь между моделями за секунду. В этой статье разбираем техническую модель ИИ-шлюзов, сопоставляем ключевые решения на российском рынке и показываем, как правильно подготовить хостинг для стабильной работы с LLM-сервисами. Далее

Мы используем файлы cookies

Продолжив работу с сайтом, вы соглашаетесь с   политикой использования файлов Cookies