Когда речь заходит об LLM и генеративном ИИ, люди обычно впадают в две крайности: либо цитируют сухие определения из учебников, либо откровенно плавают в базовых вещах вроде LLM и нейросетей.
Но есть способ не скатываться ни в одну из них.
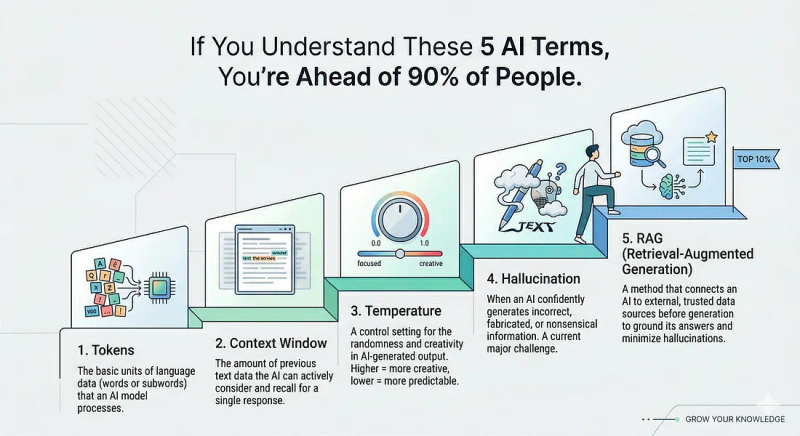
Мы выделили 5 ключевых концепций. Если вы их по-настоящему поймете, а не просто зазубрите, вы будете разбираться в теме лучше 90% людей вокруг. И неважно, кто вы: разработчик, продакт-менеджер, преподаватель или просто следите за тем, куда движется индустрия.
Итак, поехали.
1. Токены: из чего «собран» текст для нейросети
Первое, что нужно уяснить: языковые модели не читают слова. Они даже буквы не читают. Они оперируют токенами.
Что такое токен?
Представьте, что вы читаете книгу, но воспринимаете текст не целыми словами, а их фрагментами. Иногда это полноценное слово, например «кот». Иногда морфема — приставка «не-» или суффикс «-ость». А иногда и вовсе знак препинания. Этот неделимый кусочек текста и есть токен.
Например, фраза «I love pizza» разобьется на три токена: «I», « love», « pizza».
Почему это важно?
Потому что любой ИИ-продукт, которым вы пользуетесь — будь то ChatGPT, Claude или Gemini, — под капотом считает токены. Чем больше токенов в промпте, тем тяжелее работать модели. Чем длиннее сгенерированный ответ, тем дороже обходится инференс.
Когда разработчики упоминают контекстное окно модели (об этом ниже), они говорят о том, сколько токенов она может удерживать в оперативной памяти за один раз. Ранние модели вмещали около 4 000 токенов. Современные легко переваривают больше миллиона.
Именно поэтому в длинных диалогах ИИ иногда «забывает» начало разговора. Как только переписка переполняет контекстное окно, самые старые токены выгружаются из памяти — прямо как когда забивается оперативка и система начинает подвисать.
Токены — это атомы языка для ИИ. Поняв это, вы сразу увидите, почему одни промпты срабатывают лучше других, почему бот теряет нить в длинных чатах и почему в API тарификация идет за тысячи токенов.
2. Контекстное окно: почему ИИ иногда «забывает» начало диалога
Представьте собеседника с очень специфической памятью: он помнит только последние X минут разговора. Всё, что было до этого - стерто, забыто.
Это и есть контекстное окно.
Это предельный объем текста в токенах, который модель может «видеть» и обрабатывать одномоментно. Сюда входит абсолютно всё: ваши промпты, история переписки, загруженные документы и собственные ответы нейросети.
Представьте это как маркерную доску. Контекстное окно — это её физический размер. Пишите на ней что угодно. Но когда место закончится, придется стирать старое, чтобы освободить пространство для нового.
Но есть нюанс.
Маленькое контекстное окно (скажем, 4K токенов) означает, что ИИ за раз осилит лишь пару страниц текста. Загрузите длинный документ — он прочитает только вырезки. Зато большое окно (200K+ токенов) позволяет буквально скормить модели целую книгу и задавать по ней вопросы.
Именно поэтому IT-сообщество так воодушевилось, когда Claude анонсировал окно в 200 000 токенов, а Gemini начал штурмовать миллионную отметку. Этот параметр фундаментально меняет сценарии применения модели.
Практический вывод: если вы решаете сложную задачу, вроде саммаризации огромного лога или анализа массива данных, держите в уме, что ИИ-ассистент может «забыть» начало сессии. Это не баг. Это просто закончилось место на доске.
3. Температура: как управлять креативностью и точностью ответа
Когда вы просите ИИ сгенерировать текст, температура — это гиперпараметр, который определяет степень случайности и предсказуемости выдачи.
Низкая температура (ближе к 0) = модель играет по безопасным правилам. Она раз за разом выбирает наиболее вероятное, математически ожидаемое слово. Ответы получаются стабильными, точными, но пресными. Как коллега, который отвечает на письма исключительно заготовленными шаблонами.
Высокая температура (ближе к 1 и выше) = модель идет на риск. Она подбирает неочевидные слова, делает неожиданные смысловые повороты и выдает нестандартные идеи. Иногда получается гениально. Но не всегда.
Возьмем простой пример. Попросите ИИ закончить фразу: «Кот сидел на...»
При низкой температуре он почти всегда выдаст «коврике» или «полу». Предсказуемо. Безопасно.
При высокой может выдать «философском трактате» или «руинах империи».
Креативно? Безусловно. Подходит для генерации кода или составления юридического договора? Категорически нет.
Негласное правило, о котором многие не знают:
Если вы используете ИИ для строгих задач (саммаризация, написание кода, экстракция данных) — выкручивайте температуру на минимум. Модель должна быть точной, а не креативной.
Если используете для творческих задач (написание статей, брейншторм, генерация маркетинговых гипотез) — повышайте температуру. Вам нужна нестандартность.
В потребительских приложениях вроде ChatGPT этот слайдер обычно скрыт и зафиксирован на среднем значении. Но если вы работаете с AI API или профессиональными инструментами разработчика, эта настройка будет на виду. И теперь вы точно знаете, как её крутить.
4. Галлюцинации: почему ИИ уверенно врет и как это проверять
Этот термин слышали все, но далеко не все понимают механику его возникновения — а это самое важное.
Галлюцинация — это когда ИИ выдает неверный ответ с абсолютной, непоколебимой уверенностью. Никаких сомнений. Откровенный вымысел, поданный как непреложный факт.
Пример: вы спрашиваете про книгу. Модель выдает название, автора, год издания и краткий сюжет. Вот только такой книги не существует. Но ИИ отвечает так, будто цитирует Википедию.
Почему так происходит?
Главная ошибка — считать языковые модели базами данных. Они не ищут факты. Они предсказывают следующий наиболее вероятный токен, опираясь на статистические паттерны, выученные на этапе обучения. По сути, это автодополнение (autocomplete), масштабированное до размеров нейросети.
Поэтому, когда ИИ не обладает нужными данными, он не отвечает «я не знаю». Он генерирует то, что звучит как правильный ответ, потому что именно этому его и обучали.
Опасность не в том, что ИИ ошибается. Ошибаются любые инструменты. Опасность в том, что ИИ ошибается с той же абсолютной уверенностью, с какой выдает правду. Он просто генерирует текст.
Практический вывод: никогда не доверяйте ИИ вслепую, когда речь идет о фактах, статистике, медицине, юридических вопросах или продакшн-коде без код-ревью. Используйте генерацию как отправную точку, а затем верифицируйте результат. Те, кто понимает природу галлюцинаций, не отказываются от ИИ — они просто применяют его осознанно.
5. RAG: как научить модель работать с вашими документами
Самая недооцененная концепция из всей пятерки. И, честно говоря, как только вы вникнете в суть, начнете замечать её повсюду.
RAG расшифровывается как Retrieval-Augmented Generation (генерация с дополненным поиском). Идея на самом деле предельно проста.
Какую проблему это решает?
Базовая модель обучена на данных, срезанных на определенную дату. Она ничего не знает о внутренней документации вашей компании. Ничего не знает о событиях прошлой недели. Ничего не знает о том PDF, который вы только что загрузили.
Так как же тогда работают сервисы в духе «Чат с твоим PDF» или «Задай вопрос по документу»?
Это и есть RAG.
Когда вы загружаете документ, система не пихает его целиком в «мозг» нейросети. Вместо этого она разбивает текст на чанки (смысловые фрагменты) и сохраняет их в векторную базу данных, которая оперирует смыслами, а не просто матчит ключевые слова.
Затем, когда вы задаете вопрос, система сначала ищет в этой базе самые релевантные чанки, извлекает их и скармливает модели вместе с вашим промптом, как бы говоря: «Вот релевантный контекст. Теперь ответь на вопрос, опираясь на него».
Вот и всё. Извлечь нужное -> Скормить модели -> Сгенерировать ответ. RAG.
Почему это важно?
Потому что это архитектурный фундамент почти каждого полезного AI-продукта, созданного за последние пару лет. Боты поддержки, знающие внутренние регламенты; ассистенты, отвечающие на вопросы по юридическим базам; инструменты для анализа научных статей. Всё это работает на RAG.
Понимание этого механизма полностью меняет восприятие AI-продуктов. Когда ИИ «знает» ваши документы, на самом деле он ничему не дообучался. Он просто выполняет очень умный поиск и передает результаты языковой модели. Сама модель остается прежней. Меняется только поданный ей контекст.
Так почему всё это важно?
Потому что ИИ никуда не денется. И разрыв между теми, кто использует его «наугад», и теми, кто понимает базовые принципы его работы, будет только увеличиваться в ближайшие годы.
Вам не обязательно быть ML-инженером. Вам не обязательно писать код. Но понимание токенов поможет составлять более точные промпты. Понимание контекстного окна объяснит, почему ассистент внезапно потерял нить. Понимание температуры подскажет, какие параметры выбрать под конкретную задачу. Понимание галлюцинаций убережет от слепой веры в сгенерированный текст. А понимание RAG даст четкую картину того, что происходит под капотом, когда AI-сервис гордо заявляет, что «изучил ваши данные».
Всего 5 терминов. Но реальное понимание. И этого достаточно, чтобы оказаться на голову выше большинства тех, кто просто кликает по кнопкам, не понимая внутренней механики.