Это редкий случай, когда обсуждение новой модели оказалось интереснее самих её цифр. Президент OpenAI предупреждает об ускорении ландшафта угроз, глава Anthropic рассуждает о концентрации власти в ИИ, разработчики спорят о тарифах, а на фоне всего этого Z.ai тихо показывает, сколько можно выжать из пост-тренинга без новой архитектуры. Разбираем полную таблицу бенчмарков GLM 5.3, слабые места этих цифр и выводы тех, кто уже успел поработать с моделью.
Что такое GLM 5.3: та же база, новый пост-тренинг
GLM 5.3 вышла 14 августа 2026 года. Новой архитектуры в ней нет: базовая модель осталась от GLM 5.2, а весь прирост качества достигнут на этапе пост-тренинга.
По оценке аналитиков, значимость этого релиза — не столько в строчках лидербордов, сколько в том, что он демонстрирует смену самой точки прогресса: от базовой модели к пост-тренингу и инфраструктуре вокруг неё. Вопрос меняется с «кто пишет лучший код» на «кто доводит задачу до конца». В агентных сценариях узким местом всё чаще становится не модель, а всё, что её окружает, и настоящая конкуренция — в том, какая модель останется полезной после пятидесятого вызова инструмента, пятого проваленного теста и третьей смены плана. GLM 5.3 — почти чистая демонстрация этой идеи: база прежняя, результат другой.
Бенчмарки: что показывают цифры
Z.ai опубликовала результаты по трём направлениям — кодинг, агентные сценарии и кибербезопасность. Все цифры в этом разделе — из релизных материалов компании. Жирным выделен лучший результат в строке.
Кодинг
| Бенчмарк | GLM 5.3 | GLM 5.2 | Kimi K3 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.2 | 81.0 | 88.3 | 88.0 | 88.8 |
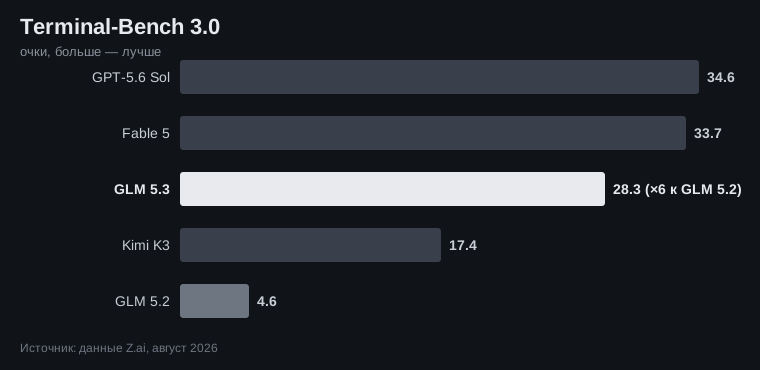
| Terminal-Bench 3.0 | 28.3 | 4.6 | 17.4 | 33.7 | 34.6 |
| DeepSWE v1.1 | 66.9 | 46.2 | 67.5 | 69.7 | 72.7 |
| NL2Repo | 58.0 | 48.9 | 58.0 | н/д | н/д |
| SWE-Marathon v1.1 | 42.5 | 19.4 | 48.1 | 33.1 | 42.5 |
| FrontierSWE | 78.1 | 67.5 | н/д | 88.2 | н/д |
Здесь видно две вещи. Первая: на старом Terminal-Bench 2.1 все пять моделей уложились в диапазон 88.0–88.8, то есть разницы между ними практически нет — расклад сил виден только на новой, третьей версии теста. Вторая: прирост относительно GLM 5.2 огромный везде (на DeepSWE — с 46.2 до 66.9, на SWE-Marathon — с 19.4 до 42.5), но в этой таблице GLM 5.3 ни разу не выходит в единоличные лидеры. На Terminal-Bench 3.0 её обходят Fable 5 и GPT-5.6 Sol, на DeepSWE и SWE-Marathon — ещё и открытая Kimi K3, а на NL2Repo с той же Kimi выходит ничья по 58.0.
Агентные сценарии
| Бенчмарк | GLM 5.3 | GLM 5.2 | Kimi K3 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| AutomationBench v1.0.6 | 48.2 | 26.2 | 46.7 | 46.2 | 45.8 |
| Agents' Last Exam (CLI) | 28.5 | 23.8 | 27.6 | 23.8 | 28.6 |
| HLE w/ Tools | 62.5 | 54.7 | 59.8 | 63.9 | 64.5 |
| GDPval-AA v2 | 1769 | 1508 | 1682 | 1743 | 1730 |
| Toolathlon Verified | 73.0 | 59.9 | 76.5 | 74.7 | 74.9 |
Здесь картина лучше: GLM 5.3 лидирует на AutomationBench и GDPval-AA v2, а на Agents' Last Exam фактически делит первое место с GPT-5.6 Sol — 28.5 против 28.6. Любопытная деталь: Fable 5 и старая GLM 5.2 в этом тесте показывают одинаковые 23.8.
Срез среди открытых моделей
Отдельно Z.ai сравнила GLM 5.3 с двумя другими моделями с открытыми весами — Kimi K3 и DeepSeek V4 Pro.
| Бенчмарк | GLM 5.3 | Kimi K3 | DeepSeek V4 Pro |
|---|---|---|---|
| Terminal-Bench 3.0 | 28.3 | 17.4 | н/д |
| DeepSWE v1.1 | 66.9 | 67.5 | 62.7 |
| NL2Repo | 58.0 | 58.0 | 61.1 |
| Toolathlon Verified | 73.0 | 76.5 | 74.1 |
| AutomationBench | 48.2 | 46.7 | 43.2 |
| Agents' Last Exam (CLI) | 28.5 | 27.6 | 25.7 |
| HLE w/ Tools | 62.5 | 59.8 | 60.0 |
| CyberGym | 84.5 | 80.0 | 83.3 |
| GDPval-AA v2 | 1769 | 1682 | 1590 |
GLM 5.3 первая в шести строках из девяти. Но не во всех: на DeepSWE и Toolathlon Verified впереди Kimi K3, на NL2Repo — DeepSeek V4 Pro, а цифры DeepSeek на Terminal-Bench 3.0 не опубликованы вовсе.
Чего цифры не показывают
Прежде чем строить планы вокруг этих чисел, стоит учесть три оговорки.
Во-первых, почти все результаты опубликованы самой Z.ai. Из всей таблицы независимо проверен только один бенчмарк — GDPval-AA v2, который напрямую прогнала лаборатория Artificial Analysis (её метриками пропускной способности, кстати, нормированы временные бюджеты в ExploitGym). Всё остальное — прогоны Z.ai в её собственном тестовом окружении и с её собственными оценками конкурентов. Это снимок от заинтересованной стороны, а не нейтральный аудит.
Во-вторых, прирост может оказаться узким. Независимая лаборатория Andon Labs обнаружила, что улучшения в кодинге не переносятся на задачи, под которые Z.ai модель целенаправленно не тренировала. На фоне общего ажиотажа это редкий трезвый замер.
В-третьих, открытые веса ещё не опубликованы. Пока файлов нет в свободном доступе (на середину августа их не было и на Hugging Face), независимо перепроверить цифры невозможно в принципе.
Кибербезопасность: главный сюжет релиза
Именно киберспособности GLM 5.3 втянули в обсуждение самых заметных людей индустрии — с реакциями от тревоги до откровенного скепсиса. Разговор быстро вырос из девелоперского твиттера в индустриальную дискуссию, и по итоговым обзорам сообщества именно эта тема стала настоящей точкой напряжения релиза.
Цифры: находить — ещё не значит взламывать
Чтобы таблица читалась, коротко о том, что измеряют эти тесты. CyberGym — сценарий «белого ящика»: исходный код доступен, нужно найти уязвимость и подтвердить её. ExploitBench — глубокий разбор известных уязвимостей, вплоть до построения рабочего эксплойта. ExploitGym — эксплуатация на время: колонки показывают, сколько задач модель решает за два и за шесть часов.
| Бенчмарк | GLM 5.3 | GLM 5.2 | Kimi K3 | Mythos 5 (Anthropic)* | GPT-5.6 Sol |
|---|---|---|---|---|---|
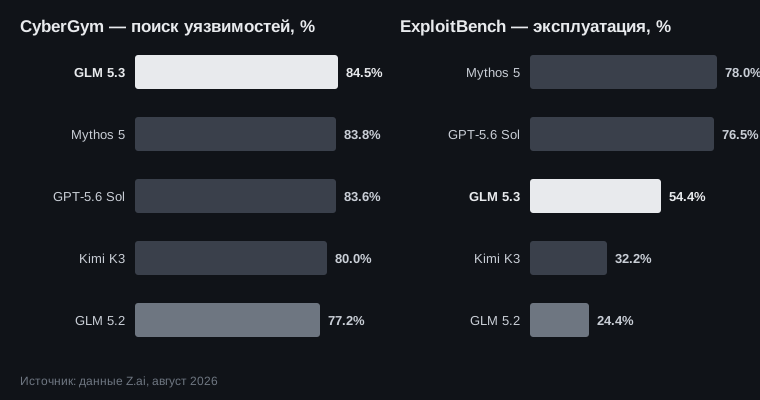
| CyberGym | 84.5% | 77.2% | 80.0% | 83.8%* | 83.6% |
| ExploitBench | 54.4% | 24.4% | 32.2% | 78.0%* | 76.5% |
| ExploitGym (2 ч / 6 ч) | 105 / 130 | 29 / 39 | 36 / 70 | 181 / 247 | 216 / 293 |
* Деталь, которую стоит знать: в кибер-блоке официального поста Z.ai колонка со значениями 83.8 и 78.0 подписана как Mythos 5, а в общей таблице та же колонка фигурирует как «Fable 5 with fallback» — то есть в собственных материалах Z.ai подписи расходятся.
Картина асимметричная, и Z.ai сама это признаёт: слоган релиза — «готова к киберзащите», а не «лучшая в атаке», и цифры это подтверждают. На CyberGym модель первая — выше и Mythos 5, и GPT-5.6 Sol. На ExploitBench она заметно позади: 54.4% против 78.0%. Иначе говоря, находить уязвимости модель научилась на уровне закрытых флагманов, а превращать их в работающие цепочки эксплуатации — пока нет. В посте Z.ai это названо «эммерджентной киберспособностью»: агент находит слабое место, разбирается в причине, проверяет цепочку. Общая закономерность такая: чем дальше тест продвинут по цепочке эксплуатации, тем больше отрыв от GLM 5.2 — и тем заметнее зазор, который ещё остаётся до закрытых флагманов.
2 436 уязвимостей на живых кодовых базах
За этими цифрами стоит полевая работа: с июня Z.ai прогоняла модель по реальным репозиториям вместе с китайскими командами по информационной безопасности. После экспертного разбора получилось 2 436 находок в 269 проектах; 1 097 из них получили оценку критической или высокой тяжести.
Откуда шумиха: уязвимость в Cursor
Спусковым крючком дискуссии стало заявление самой Z.ai. По данным VentureBeat, девелопер-адвокат компании Лу сообщила, что GLM 5.3 обнаружила «потенциально серьёзную уязвимость» в Cursor — популярном редакторе кода с ИИ. Находку раскрыли разработчикам приватно, а на момент публикации подтверждения от Cursor не было. Поэтому корректно считать это заявлением, а не установленным фактом.
Кто как отреагировал
| Кто | Позиция | Суть |
|---|---|---|
| Грег Брокман, президент OpenAI | Тревога | Модель может «значительно ускорить развитие ландшафта угроз» |
| Security-аналитики | Скепсис, местами отторжение | Возражения на тезис Брокмана |
| Дарио Амодеи, CEO Anthropic | Отдельный аргумент | Открытые веса не решают более глубокую проблему — концентрацию власти в ИИ |
| Chubby (@kimmonismus), комментатор | Внимание к цифрам | Отметил, что 84.5% на CyberGym позволили обойти Mythos 5 от Anthropic (83.8%) |
| VentureBeat / Z.ai | Заявление (не подтверждено) | «Потенциально серьёзная уязвимость» в Cursor, раскрыта приватно |
| Andon Labs | Трезвый замер | Прирост в кодинге не переносится на задачи, под которые модель не тренировали |
| FavTutor, Build Fast with AI | Сбалансированный вердикт | Сильна в киберзащите и по цене, уступает Fable 5 на самом сложном кодинге |
Что говорят тестеры: выносливость и цена
Выносливость. Отдельный сюжет — длинные агентные прогоны. Демонстрация GLM 5.3 длилась больше четырёх часов на одной задаче, и внимание привлекла именно длительность, а не результат. Z.ai описывает тренировочные среды, где одна задача эквивалентна нескольким дням работы опытного инженера: модель получает доступ к кодовым базам, документации и вычислительным ресурсам и должна сама поставить диагноз проблемы и довести решение до конца. Правда, из демонстрации непонятно, сколько подсказок модель получала по ходу, поэтому она доказывает выносливость, но не полную автономность. Вывод практиков звучит так: способность часами удерживать контекст задачи впечатляет и важна для длинных агентных циклов, но о работе без присмотра говорить пока рано.
Цена. С моделью напрямую работали больше пятнадцати тестеров, и здесь мнения разделились интересным образом. По стоимости самих запросов вердикт единодушен: в одном из прямых сравнений GLM 5.3 выдала качество почти на уровне Fable 5 за малую долю её цены. Независимые обзорщики FavTutor и Build Fast with AI сошлись в одном: модель сильна в киберзащите и соотношении цены и качества, но на самом сложном кодинге уступает Fable 5. Сатвик Парамкушам из Build Fast with AI устроил очное сравнение сразу по пяти направлениям и получил честный раздел: Fable 5 забрала чистый кодинг и наступательную эксплуатацию, GLM 5.3 — защитную кибербезопасность и выгоду по цене, а в агентном кодинге модели оказались близки. Его итоговая формулировка: GLM 5.3 — это не «так же хорошо, как Fable 5», а, возможно, кое-что поважнее: открытая модель, которая подобралась по кодингу достаточно близко, чтобы её нельзя было игнорировать.
А вот к тарифным планам отношение заметно прохладнее — структура подписок вызвала нарекания даже у тех, кому модель понравилась. На Reddit в сообществе r/ZaiGLM мнения разделились: один участник назвал кодинг-план дорогим на фоне Codex за 20 долларов в месяц, другой описал картину из своей консалтинговой практики — клиенты переходят на открытые модели, а Claude оставляют для всё более узкого круга задач. Общий вердикт рецензентов можно сформулировать так: GLM 5.3 — это специалист, а не универсал. Она выигрывает в киберзащите и цене, проигрывает в самом тяжёлом кодинге, и в итоге выбор почти всегда решает стоимость.
API: уровни усилий, токены и миграция
Три практических момента для тех, кто подключает модель через API:
- Режим рассуждения всегда включён. Отключить «мышление» больше нельзя.
- Есть три уровня усилий: low, high и max. Для кодинга рекомендуется max.
- Перед сменой ID модели нужна миграция. Старые запросы с отключённым рассуждением при переходе на
glm-5.3будут падать с ошибкой — их нужно переписать заранее.
Насколько важен выбор уровня усилий, показывает внутренний тест Z.ai Code Bench — замер результата в зависимости от бюджета выходных токенов:
| Модель и уровень усилий | Результат | Выходные токены (примерно) |
|---|---|---|
| GLM 5.3 Max | 34.5% | 75K |
| GLM 5.3 High | 31.4% | 50K |
| GLM 5.2 Max | 23.4% | 96K |
| Claude Opus 4.8 | 29.5% | 120K |
| Claude Fable 5 Max | 39.5% | не указано |
Данные Z.ai, август 2026. Учтите: Z.ai Code Bench — закрытый тест, по одним опубликованным процентам его извне не воспроизвести.
Из таблицы видна экономика токенов: GLM 5.3 на уровне high обходит максимум GLM 5.2 (31.4% против 23.4%), потратив примерно вдвое меньше выходных токенов — 50 тысяч против 96. А GLM 5.3 Max выше Claude Opus 4.8 (34.5% против 29.5%) при заметно меньшем бюджете (75 тысяч против 120). Впереди только Fable 5 Max — 39.5%.
Открытые веса: когда и что проверять
Z.ai пообещала опубликовать веса примерно через две недели после запуска — ориентировочно в конце августа 2026 года, после завершения проверки безопасности и дополнительной доработки модели. Показательно, что причиной поэтапного релиза названы именно киберспособности: веса решили удержать до завершения оценки.
Когда файлы появятся, перед использованием стоит проверить:
- лицензию;
- хэши файлов;
- токенизатор;
- требования к железу;
- и главное — что скачанная версия ведёт себя так же, как облачный API, прежде чем строить на ней рабочие системы.
Выводы: кому подходит GLM 5.3
GLM 5.3 — агрессивный апдейт пост-тренингом на прежней базе. Что в сухом остатке: шестикратный рост на Terminal-Bench 3.0 относительно GLM 5.2, первое место на CyberGym среди всех участников сравнения, лидерство в двух агентных тестах и в шести строках из девяти среди открытых моделей. Обратная сторона: в большой таблице по кодингу модель ни разу не выходит в единоличные лидеры, а в эксплуатации уязвимостей заметно уступает закрытым флагманам. Плюс общий вердикт тестеров — отличное соотношение цены и качества при уступке Fable 5 на самом сложном кодинге.
Модель — рабочий вариант уже сегодня, если вы оптимизируете стоимость кодинг- и агентных сценариев (обратите внимание на уровень high, который даёт результат выше максимума прошлого поколения при вдвое меньшем токен-бюджете), если вам нужен поиск уязвимостей, а не их эксплуатация, и если вас устраивает всегда включённый режим рассуждения.
Стоит подождать, если вам нужен самый сильный кодинг без компромиссов — здесь впереди Fable 5, а также если нужны независимые прогоны бенчмарков или локальный запуск: до публикации весов и проверок остаётся ещё пара недель.
Как попробовать GLM 5.3
GLM 5.3 уже доступна в LLM-инференсе Dockhost — облачной PaaS для запуска приложений в контейнерах. Один API-ключ даёт доступ к ведущим моделям, оплата — в рублях, без аккаунтов в зарубежных сервисах. Подключайте модель и проверяйте цифры из этой статьи на своих задачах: агентный кодинг на уровне max, сценарии поиска уязвимостей, сравнение с текущим стеком — всё это тестируется за один вечер.
Попробовать GLM 5.3 на Dockhost →
Источники
- GLM 5.3 Review: What the AI Community Is Actually Saying — обзор реакций сообщества: Грег Брокман, Дарио Амодеи, Andon Labs, сравнение Build Fast with AI, обсуждения на Reddit, кейс с Cursor.
- GLM 5.3 Benchmarks: What the Numbers Show & What They Don't — разбор бенчмарков Z.ai, независимая проверка GDPval-AA v2, статус открытых весов.