Раньше запуск серьёзного локального кодинг-агента неизбежно требовал компромиссов: приходилось либо мириться со слабой моделью, либо покупать рабочую станцию, либо тихо возвращаться к облачным API. Qwen 3.8-27B меняет эти правила игры. Её веса занимают от 15,7 до 17,9 ГБ, благодаря чему карты уровня RTX 3090 и RTX 4090 перестают быть просто теоретическим минимумом. Теперь на них можно реально развернуть открытую модель для генерации кода, сохранив достаточный запас видеопамяти для полезной работы.
Первые результаты бенчмарков впечатляют. Сама команда Qwen заявляет о 73,0 баллах на Terminal Bench 2.1 и 61,7 на SWE-bench Pro (против 63,4 и 53,5 у предыдущей Qwen 3.6-27B). Это данные вендора, а не независимый аудит. Тем не менее прирост настолько ощутим, что Qwen 3.8 мгновенно возглавляет шорт-лист локальных моделей для видеокарт с 24 ГБ VRAM.
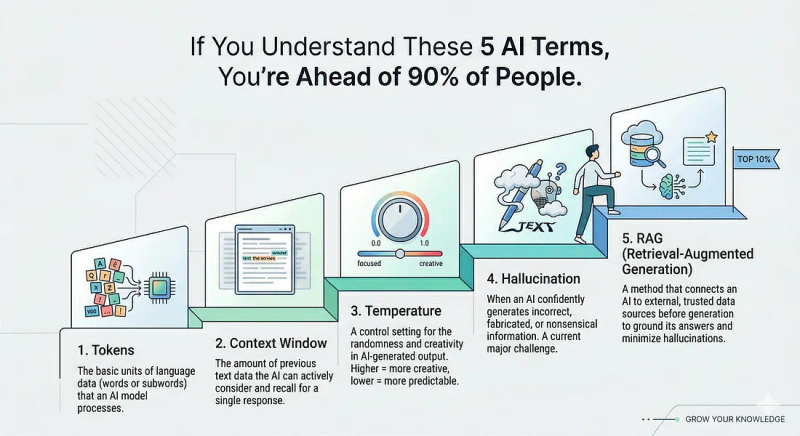
Правда, в хайпе вокруг локального ИИ часто упускают важный нюанс: файл с весами на 17 ГБ — это не 17 ГБ потребления в рантайме. KV-кэш, рабочие буферы, драйверы, обработка изображений и контекст быстро съедают остаток памяти. Qwen заявляет нативное контекстное окно в 262 144 токена и до 1 миллиона с YaRN, но не стоит рассчитывать на комфортные сессии в 262K на одной потребительской карте с 24 ГБ. Начните с квантования Q4 и разумного бюджета контекста — даже в таком виде это куда более мощный локальный сетап, чем всё, что индустрия предлагала поколение назад.
Что именно представила Qwen
В официальной карточке Qwen/Qwen3.8-27B модель описана как плотная (dense) каузальная языковая модель на 27B параметров с вижн-энкодером, 64 слоями, лицензией Apache 2.0, поддержкой анализа фото и видео и нативным контекстным окном на 262 144 токена.
Плотная архитектура на 27B здесь принципиальна. Это не миниатюрная моделька, обвешанная модными терминами про «агентов», и не гигантский класс моделей, негласно требующий серверных кластеров. Qwen бьёт точно в цель: компактная открытая модель, способная вдумчиво читать репозиторий, писать патчи, вызывать инструменты и реагировать на фидбек окружения, не требуя выхода за рамки потребительских видеокарт.
В этом и заключается ценность релиза. Если параметры из карточки и страницы квантования соответствуют действительности, Qwen 3.8-27B переводит локальных кодинг-агентов из категории «посмотреть демо» в категорию «можно внедрять в пайплайн».
Бенчмарки
Официальная таблица бенчмарков Qwen — главный аргумент релиза, поэтому приведём её в начале. Но здесь же важно сделать ремарку: это собственные тесты Qwen, а не независимый слепой тест.
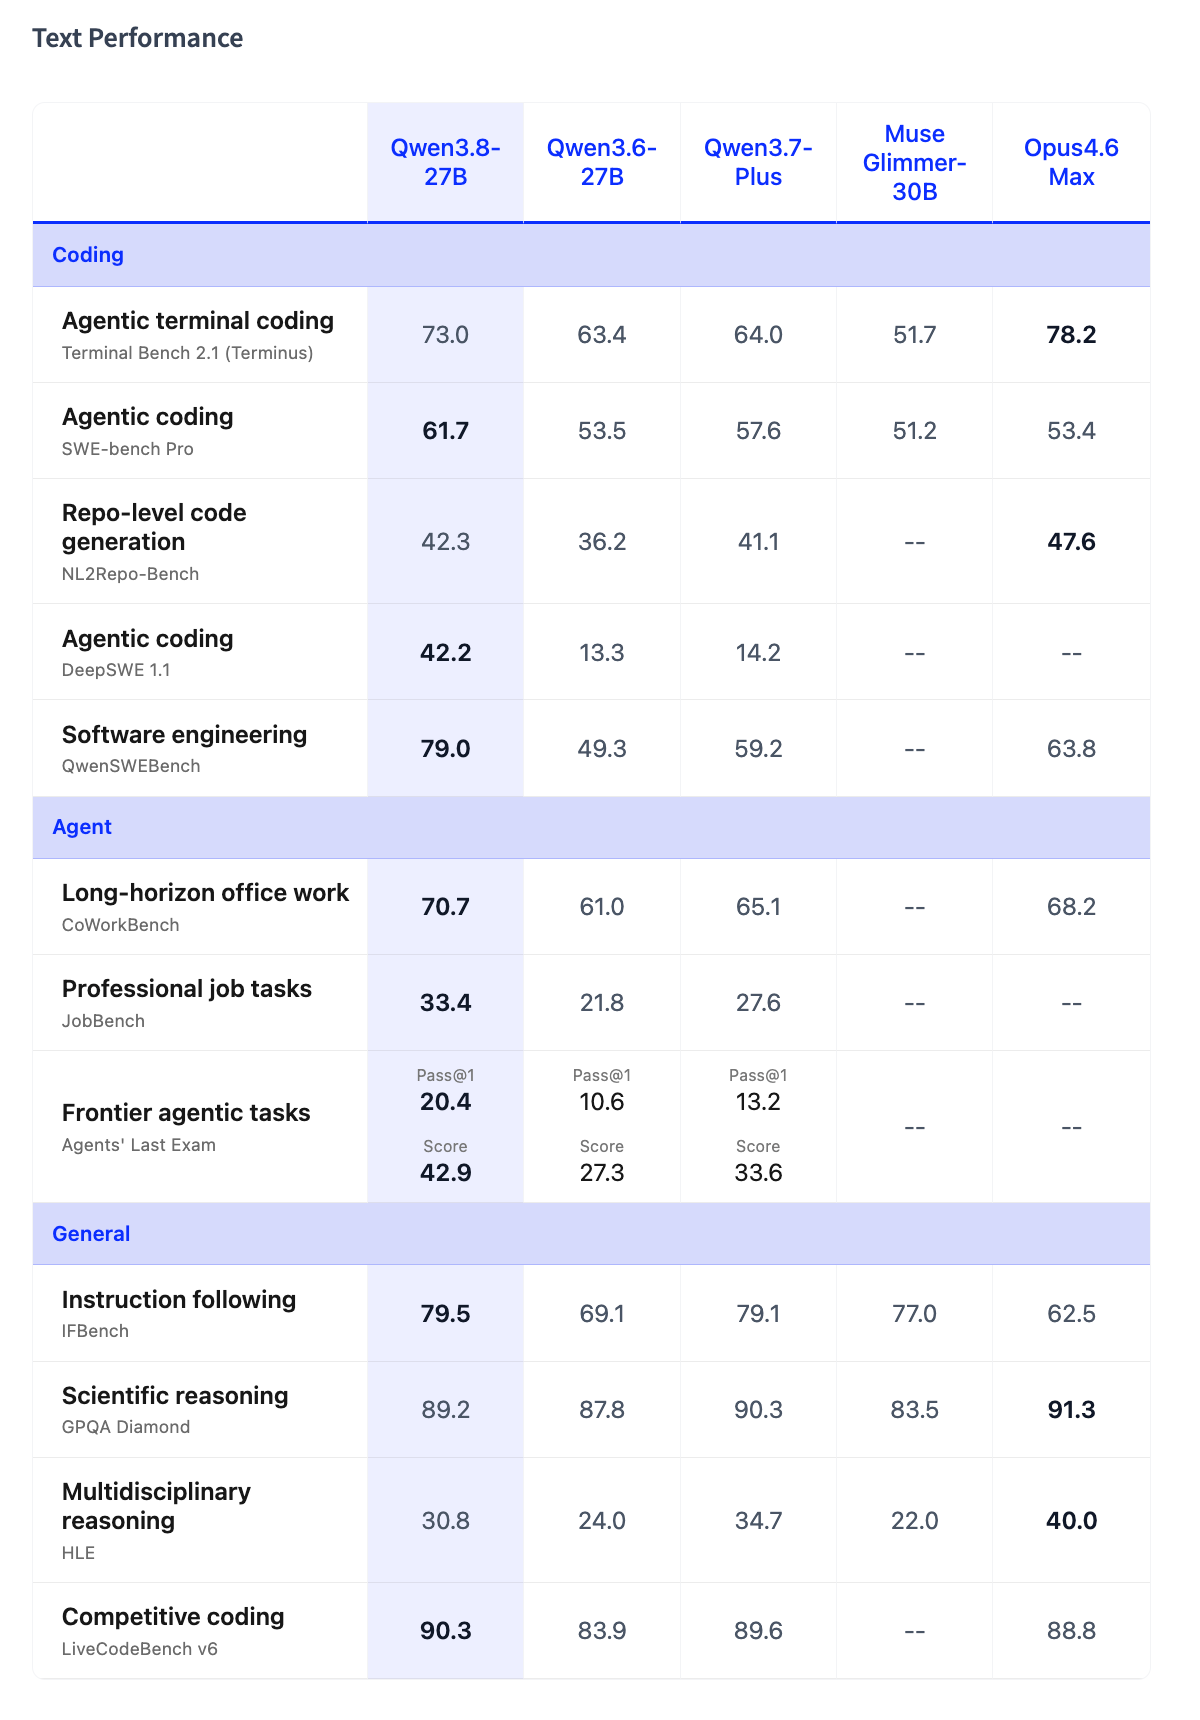
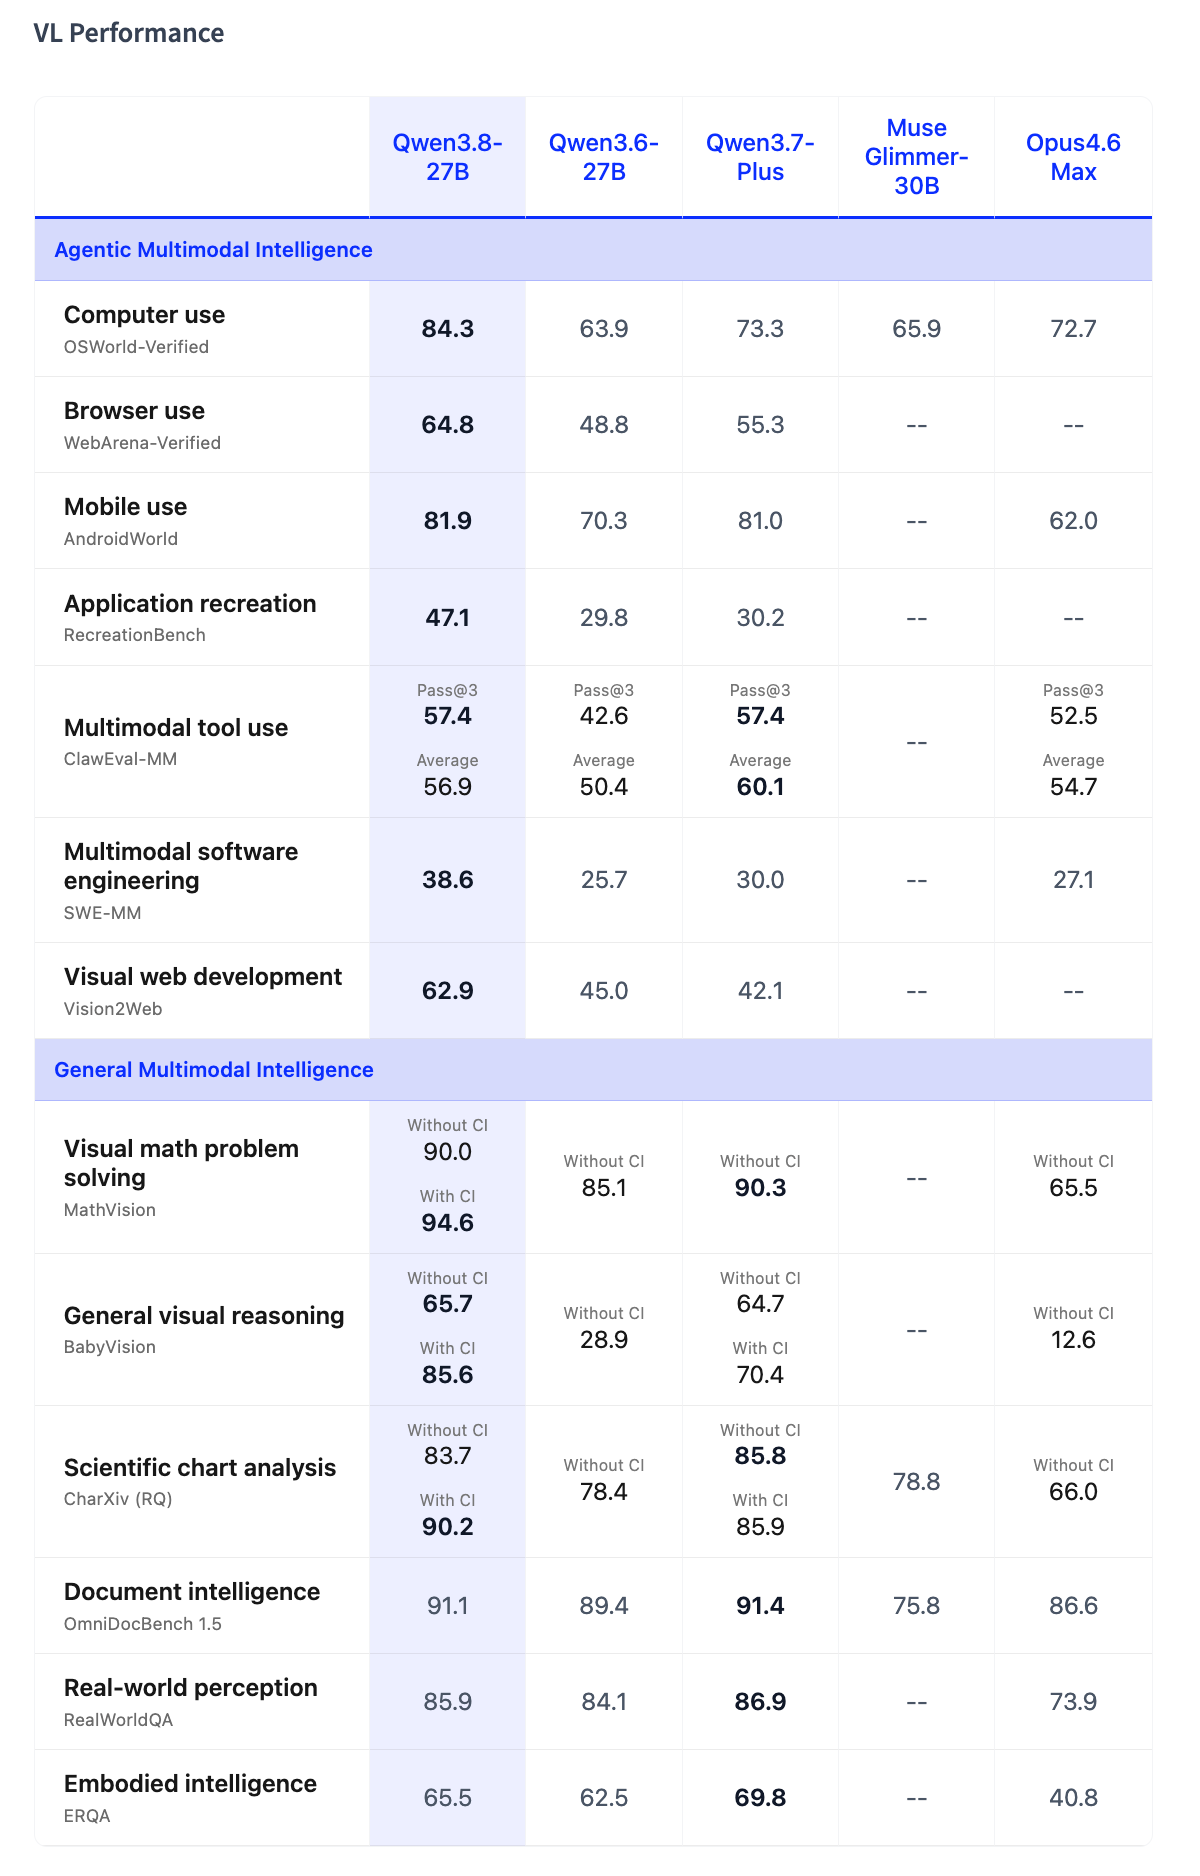
В вендорской таблице зафиксированы следующие результаты:
- Qwen3.8-27B: 73,0 на Terminal Bench 2.1 и 61,7 на SWE-bench Pro.
- Qwen3.6-27B: 63,4 и 53,5.
- Muse Glimmer-30B: 51,7 и 51,2.
- Opus4.6 Max: 78,2 и 53,4.
Qwen уточняет, что все замеры (кроме результата Opus) проводились через Claude Code с температурой 1.0, top_p 0.95 и окном контекста 256K. Также сообщается, что некорректные задачи были исправлены, а базовые показатели пересчитаны. Раскрытие методологии похвально, но цифры всё равно остаются вендорскими.
Из таблицы можно сделать три ключевых вывода:
- Разрыв с Qwen3.6-27B колоссален. Рост с 63,4 до 73,0 на Terminal Bench 2.1 и с 53,5 до 61,7 на SWE-bench Pro — это качественный скачок, а не погрешность измерений.
- Это не повод кричать об «убийце Opus». Qwen3.8-27B отстаёт от Opus4.6 Max на Terminal Bench 2.1, хотя и опережает её на SWE-bench Pro. Перед нами смешанный результат, а не безоговорочный нокаут.
- Muse Glimmer-30B остаётся сильным соперником. Разработчики Qwen сами включили её в бенчмарк: в сегменте идёт реальная конкурентная борьба, а не сольное выступление.
Почему 24 ГБ — это реалистично, но пока не гарантировано
Конкретика по требованиям к железу появляется на странице Unsloth с GGUF-квантованиями.
- Q4: IQ4_XS — 15,7 ГБ; Q4_K_S — 16,1 ГБ; Q4_K_M — 17,1 ГБ; UD-Q4_K_XL — 17,9 ГБ.
- Q5: от 19,3 до 20,2 ГБ — рабочего запаса на карте с 24 ГБ остаётся заметно меньше.
- Q6: 22,9 ГБ — слишком впритык, чтобы назвать это комфортным без реального теста рантайма.
- Q8: 29 ГБ — уже за пределами 24 ГБ ещё до накладных расходов рантайма.
Этих данных достаточно для взвешенного вывода: 24 ГБ VRAM — это реалистичный порог входа для тестов Qwen3.8-27B в формате Q4.
Но заявлять о стопроцентной стабильности рано: на странице указан чистый размер весов, а не сквозное потребление памяти. В VRAM ещё должны поместиться KV-кэш, системные буферы, оверхед инференс-движка, резерв драйвера ОС и реальный рабочий контекст сессии.
Резюме по запуску на 24 ГБ
Чтобы трезво оценить требования к оборудованию, зафиксируем факты:
- Q4 на 24 ГБ: веса 15,7–17,9 ГБ оставляют запас памяти. Именно поэтому Q4 — лучший кандидат для первых тестов.
- Q5 на 24 ГБ: диапазон 19,3–20,2 ГБ может запуститься впритирку, но объём оставшейся памяти ставит стабильность под вопрос.
- Q6 на 24 ГБ: 22,9 ГБ не оставляют запаса уже на этапе загрузки весов. Не стоит строить агентные пайплайны на этом квантовании без прямых замеров.
Длинный контекст: поддержка 262K нативно и 1 млн токенов через масштабирование заложена в архитектуру модели, но это не означает лёгкую работу с максимальным контекстом на одной потребительской GPU на 24 ГБ.
Тезис о доступности 24 ГБ — это инженерный вывод из спецификаций и размера весов, а не результат полного профилирования.
Анатомия памяти: веса — это только верхушка айсберга
Многие сводят потребление ресурсов к одной цифре, хотя в реальности память делится на три разных пула:
- Веса модели — скачанный квантованный файл. Для Qwen 3.8-27B в Q4 Unsloth указывает 15,7–17,9 ГБ. Это доказывает, что веса поместятся на видеокарту с 24 ГБ, но не гарантирует, что там поместится весь агентный цикл.
- VRAM в рантайме — кроме весов, вмещает KV-кэш, вычислительные буферы, состояние attention, обработку картинок и резерв видеодрайвера. Кэш растёт пропорционально длине диалога. Разовый вопрос на пару тысяч токенов и агентная сессия (с индексацией репозитория, логами тестов, скриншотами интерфейса и серией правок кода) создают абсолютно разную нагрузку на память. Поэтому сетап на 24 ГБ с Q4 отлично применим на практике, а вот попытка сразу выкрутить контекст на 262K приведёт к OOM (Out of Memory).
- Системная RAM и Unified Memory — отдельная плоскость. Десктопная система может сбросить часть слоёв модели в обычную оперативку (offloading), но это несравнимо со скоростью чистой VRAM. Чипы Apple Silicon распределяют объединённую память иначе: веса и рантайм делят один пул, что позволяет вместить модель крупнее, но не превращает Mac с базовой памятью в высокопроизводительный GPU-кластер.
Итоговое правило: 24 ГБ VRAM — идеальная точка для тестов Q4; 16 ГБ потребуют жёстких компромиссов; 32 ГБ и выше дают комфортный запас под Q5, длинный контекст и оверхед агента.
Контекстное окно: число выросло, локальный предел никуда не делся
Заявленные 262 144 нативных токена и масштабирование RoPE (например, через YaRN) до 1 миллиона — впечатляющий показатель для локальной плотной модели на 27B. Архитектура позволяет анализировать огромные кодовые базы, историю коммитов и длинные цепочки вызова инструментов без принудительного усечения контекста.
Однако нативный лимит модели — это не рекомендация по аллокации памяти на пользовательском GPU. Реально доступная длина контекста зависит от формата квантования, движка инференса, объёма VRAM, настроек KV-кэша и мультимодальной нагрузки. Агенту не обязательно (и чаще всего противопоказано) аллоцировать максимум контекста со старта. Рабочее окно в 32K или 64K с агрессивной суммаризацией промежуточных выводов терминала — куда более прагматичный подход, чем попытка занять 262K ради красивых цифр.
Для сравнения: Meta заявляет для своей агентной модели Muse Glimmer (~29,6B) контекст от 131 072 токенов. Преимущество Qwen в 262K на бумаге выглядит внушительно при анализе больших документов. Но на карте с 24 ГБ это не превращается автоматически в двукратный выигрыш на практике. Как только KV-кэш начинает доминировать в расходе видеопамяти, соревнование спецификаций уступает место инженерии рантайма.
Qwen 3.8 отлично подготовлена к длинному контексту, но правильный вопрос звучит не «поддерживает ли она 262K?», а «какой объём репозитория, логов и шагов задачи можно держать в памяти до того, как система начнёт тормозить или падать?».
Позиционирование среди альтернатив
Ценность релиза очевидна, если взглянуть на выбор моделей с точки зрения архитектурной маршрутизации:
- Qwen3.6-27B — прямой предшественник. Если цифры бенчмарков верны, версия 3.8 — это качественный прорыв, а не косметический апдейт.
- Qwen3.7-Plus — ориентир внутри семейства для калибровки результатов.
- Muse Glimmer-30B — главный соперник. Meta тоже продвигает модель класса ~30B под Apache 2.0 для локальных агентов. Карточка meta-models/Muse-Glimmer-30B заявляет около 29,6B параметров, включая энкодер восприятия, плотную архитектуру, мультимодальность, восстановление после сбоев (failure recovery) и поддержку инструментов. Это создаёт полноценную конкуренцию.
- Opus4.6 Max — напоминание о границах возможного. В бенчмарках Qwen модель Opus всё ещё удерживает лидерство на Terminal Bench 2.1.
Почему Qwen 3.8 важнее облачных флагманов
Главное достоинство Qwen 3.8 — не попытка стать «убийцей облаков», а то, что модель осталась в прежнем классе по «железу», показав колоссальный прогресс в сопутствующих агентных задачах.
Разрыв между 3.6 и 3.8 составляет 9,6 балла на Terminal Bench 2.1 и 8,2 балла на SWE-bench Pro. Важны не просто цифры, а качественный сдвиг: планирование, вызов инструментов, реакция на вывод терминала и самовосстановление после ошибок стали ключевыми свойствами модели. Локальному агенту не нужно побеждать во всех логических загадках: ему достаточно прочитать репозиторий, подготовить патч, выполнить тест, разобрать трейсбек ошибки и внести корректную правку со второй попытки — не исчерпав при этом лимит видеопамяти.
Именно поэтому не стоит оставаться на Qwen 3.6 по привычке. Заявленный прирост оправдывает прямое A/B-тестирование на вашей кодовой базе. Возьмите конкретную изолированную задачу: одну небольшую фичу, один упавший юнит-тест, небольшой рефакторинг — и посмотрите, будет ли итоговый дифф рабочим.
Заключение
Qwen 3.8-27B выглядит одним из самых убедительных кандидатов на роль локального кодинг-агента в своём классе.
Главное здесь — не заявления в духе «мы обошли всех». Главное — цельность релизного пакета: заметный рост качества кода, квантования Q4 под доступные 24 ГБ VRAM, открытая лицензия и изначальная оптимизация под вызов инструментов, а не под чат-диалоги.
Но сохраняйте прагматизм: бенчмарки предоставлены вендором, а применимость на 24 ГБ рассчитана по размеру весов, а не по финальным стресс-тестам. Следующий логичный шаг — развернуть агента на реальной машине с 24 ГБ и проверить его в деле.