В 2026 году OpenCode преодолел отметку в 165 000 звёзд на GitHub и стал самым популярным открытым агентом для разработки — с большим отрывом. По разным оценкам, количество ежемесячно активных разработчиков выросло с 2,5 миллионов в феврале до более чем 7 миллионов к июню. Рост настолько стремительный, что любая конкретная цифра, скорее всего, устареет к тому моменту, когда вы это прочитаете.
Популярность означает, что недостатка в материалах формата «вот как это установить» нет. Гораздо меньше написано о том, что отличает человека, который однажды запустил OpenCode, от того, кто действительно построил вокруг него рабочую, гибкую к моделям, автоматизированную среду разработки.
Отчасти этот пробел существует потому, что главное преимущество OpenCode — независимость от провайдеров (с поддержкой более 75 AI‑провайдеров) — одновременно делает написание единого руководства сложнее. Руководство, специфичное для Claude Code, может на протяжении всего текста опираться на особенности одного вендора. Полезное руководство по OpenCode обязано охватывать конфигурацию, права доступа и решения о рабочих процессах — те, которые инструмент с одним вендором просто не заставляет вас принимать.
Именно это по большей части отличает ранние этапы от поздних: ранние этапы почти универсальны для любого агента разработки, тогда как поздние посвящены именно тем решениям, которые даёт гибкость OpenCode.
Это пошаговый путь из десяти этапов, а не краткое руководство по запуску. Каждый этап строится на предыдущем, и большинство людей могут пройти первые четыре‑пять за выходные. Поздние этапы — собственные инструменты и понимание на уровне фреймворков — это момент, когда «использование OpenCode» превращается в «быть экспертом по OpenCode».
Этап 1: изучите CLI и начните с небольших репозиториев
Установите через curl -fsSL https://opencode.ai/install | bash или npm i -g opencode-ai — в зависимости от того, что лучше вписывается в ваш существующий набор инструментов. Не стоит направлять его на самый большой и запутанный репозиторий в первый же день. Начните с чего‑то достаточно маленького, чтобы вы могли прочитать каждый файл, к которому он обращается, и вручную проверить каждое изменение.
Важная привычка, которую стоит выработать сразу: проверяйте, что именно изменил OpenCode, непосредственно после каждого изменения, а не считайте сессию завершённой, когда он перестаёт говорить. Режим Build применяет правки напрямую: по умолчанию нет запроса подтверждения, блокирующего каждое изменение, — поэтому проверка diff (списка изменений) остаётся на вашей стороне, а не выступает контрольной точкой, которую обеспечивает сам инструмент.
TUI (текстовый интерфейс) показывает diff по мере их появления, а не только итоговую сводку. Умение комфортно читать этот поток — фундамент для всего, что следует далее. Те, кто пропускает этот шаг, часто оказываются в одной из двух крайностей: либо чрезмерно доверяют инструменту (предполагая, что изменения были проверены, хотя на самом деле ничто их не валидировало), либо чрезмерно ему недоверяют (проверяя настолько тщательно, что это не быстрее, чем писать код самостоятельно).
Этап 2: пишите промпты с целями, ограничениями и способом проверки
Расплывчатый промпт даёт правдоподобно выглядящий, но непроверенный результат. Хороший промпт явно указывает три вещи: что вы хотите получить, чего не следует трогать или менять и как вы поймёте, что всё сработало.
Сравните: «исправь баг со входом» и «форма входа принимает пустые пароли, когда поле email автозаполнено; исправь валидацию так, чтобы пустые пароли всегда отклонялись, не трогай саму обработку автозаполнения и добавь тест, который отправляет пустой пароль с предзаполненным email». Вторая версия даёт агенту чёткую цель, границы допустимых изменений и способ проверить свою работу перед тем, как вернуть её вам.
Эта привычка важнее любой настройки конфигурации на всём этом пути. Большинство разочаровывающих сессий с OpenCode связаны именно с недостаточно детализированным промптом, а не с ограничениями самого инструмента.
Этап 3: поймите, как OpenCode обнаруживает контекст репозитория
OpenCode ищет файл AGENTS.md, чтобы подхватить конвенции вашего проекта, и разрешает приоритеты в определённом порядке: AGENTS.md на уровне проекта побеждает глобальный ~/.config/opencode/AGENTS.md. Если в одном и том же месте существуют оба файла — AGENTS.md и CLAUDE.md, — приоритет остаётся за AGENTS.md.
Эта логика приоритетов — собственная разработка OpenCode. Её важно учитывать, если вы переходите из инструмента с другой конвенцией правил, например, из Cursor (.cursorrules): имена файлов и порядок разрешения в них не переносятся.
Также можно указать OpenCode на дополнительные файлы инструкций, в том числе на удалённые URL‑адреса, через opencode.json. Это полезно, чтобы передать командные правила всей команде без необходимости копировать одни и те же конвенции в каждый репозиторий. Удалённые инструкции загружаются с пятисекундным таймаутом — не стоит рассчитывать на доступность медленного эндпоинта в середине сессии.
Правильно составленный на раннем этапе файл сэкономит много времени на повторных исправлениях позже. В него стоит включать реальные конвенции проекта, а не общие советы, которые модель и так знает. Например, укажите фреймворк тестирования, формат commit‑сообщений, запрещённые для изменений директории, правила обработки ошибок. Короткий и специфичный файл эффективнее длинного и общего.
Пример AGENTS.md:
# AGENTS.md
- Run tests with `pnpm test`, not `npm test`, the npm script is legacy.
- Never edit anything under /generated or /vendor.
- Commit messages: imperative mood, under 72 characters, no period.
- All new API endpoints need a corresponding test in /tests/api.Этап 4: изучите Git‑центрированный рабочий процесс
Обычный цикл работы с OpenCode повторяет подход внимательного инженера: создайте feature‑ветку, позвольте агенту внести точечные изменения, проверьте diff, зафиксируйте правки с осмысленным сообщением коммита, затем откройте pull request (PR, запрос на слияние). Относитесь к каждой сессии OpenCode как к работе младшего инженера — она достойна проверки, но не должна сливаться без контроля.
Два встроенных основных агента напрямую соответствуют этому рабочему процессу. Режим Build имеет полный доступ к редактированию и оболочке — его используют, когда готовы вносить изменения. Режим Plan по умолчанию работает в режиме «только для чтения» (в конфигурации разрешений: edit: deny, bash: deny). Это оптимальный вариант для исследования кодовой базы или подготовки наброска подхода — до того, как позволить агенту менять файлы. Переключение между режимами с помощью клавиши Tab (вместо постоянного использования Build по умолчанию) — простая привычка, которая помогает избежать множества нежелательных правок на этапе анализа задачи.
Освоив эту механику, стоит закрепить подход «в два прохода»:
- Используйте режим Plan, чтобы агент проанализировал релевантные файлы и предложил общий план действий на естественном языке.
- Самостоятельно проверьте этот план.
- Затем переключитесь в режим Build и дайте агенту промпт, который прямо ссылается на уже согласованный подход — вместо того чтобы заново описывать всю задачу с нуля.
Такой двухэтапный подход позволяет выявить ошибочную логику ещё до написания кода. Исправить неверный план значительно дешевле, чем разбираться с неправильной реализацией, которую потом придётся проверять, откатывать и переделывать.

Этап 5: свободно овладейте инструментами, к которым OpenCode реально имеет доступ
Выполнение shell‑команд, редактирование файлов, поиск и тестирование — это базовые примитивы, на которых строится вся работа с агентом. При этом поиск зачастую недооценивают: агент, который умеет эффективно использовать grep и навигироваться по кодовой базе, задаёт меньше уточняющих вопросов и не тратит контекст на повторное чтение уже просмотренных файлов. Это ощутимо влияет на стоимость и скорость решения задач, особенно если они затрагивают больше пары файлов.
Не менее важна интеграция с тестированием: когда агент может запустить ваш реальный набор тестов сразу после внесения правок, он способен обнаружить собственные регрессии ещё до того, как вы увидите diff. Так вы избегаете ситуаций, когда ошибка всплывает уже на этапе ручного ревью или — что хуже — в CI (системе непрерывной интеграции).
Две особенности этого этапа выводят работу с инструментами за рамки простого «разрешить агенту запускать команды»:
- Интеграция с LSP (Language Server Protocol). OpenCode передаёт в модель реальные диагностики от компилятора и языкового сервера после каждой правки. Заявлена поддержка более чем 20 языков — но эту цифру стоит проверять по актуальной документации именно для вашего стека, а не принимать как универсально подтверждённую. Такой сигнал принципиально отличается от простой проверки «похоже ли это на валидный синтаксис»: благодаря LSP агент быстрее находит ошибки типов, битые импорты и другие проблемы, которые видны только при полноценной языковой семантике.
- Гибкая настройка области разрешений для инструментов. Вам не нужно давать агенту всеобъемлющий доступ. В конфигурации
toolsможно включать или отключать отдельные возможности (например,write,bashи др.) как глобально, так и для каждого агента отдельно. При этом настройки конкретного агента имеют приоритет над глобальными. Например, агент для исследований с ограничениемbash: falseдействительно не сможет выполнять shell‑команды — это не просто рекомендация в системном промпте, а жёсткое техническое ограничение. Такой подход позволяет безопасно разделять сценарии: один агент — для анализа и планирования, другой — для внесения изменений.
Этап 6: сконфигурируйте несколько моделей и определите, когда каждая заслуживает своего места
В этом — ключевое отличие OpenCode от инструментов, привязанных к одному вендору. Платформа поддерживает более 75 провайдеров: Anthropic, OpenAI, Google, AWS Bedrock, Azure, Groq, OpenRouter, а также локальные модели через Ollama или любой OpenAI‑совместимый эндпоинт. Настройте модель для каждого агента в opencode.json:
{
  "$schema": "https://opencode.ai/config.json",
  "agent": {
    "build": {
      "mode": "primary",
      "model": "anthropic/claude-sonnet-4-20250514",
      "permission": { "edit": "allow", "bash": "allow" }
    },
    "plan": {
      "mode": "primary",
      "model": "anthropic/claude-haiku-4-20250514",
      "permission": { "edit": "deny", "bash": "deny" }
    }
  }
}
Важный нюанс про Claude, который нужно учитывать при настройке: по состоянию на начало 2026 года компания Anthropic заблокировала использование учётных данных подписок Claude Pro и Max внутри сторонних инструментов, включая OpenCode. В феврале 2026 года мейнтейнеры OpenCode полностью удалили обходной код. Позиция Anthropic состояла в том, что условия подписки изначально не предназначались для программного доступа через сторонние приложения. Сейчас документация провайдеров в OpenCode прямо указывает: такой способ использования подписок не поддерживается.
На практике это значит, что для работы моделей Claude в OpenCode теперь требуется стандартный API‑ключ Anthropic с оплатой по токенам — а не логин по подписке Pro или Max. Это меняет экономическую модель использования Claude по сравнению с провайдерами, где подписной доступ по‑прежнему работает. Именно здесь становится особенно ценной гибкость выбора провайдеров: если условия доступа у одного из них внезапно меняются, вы можете обойти проблему простым изменением конфигурации, а не оказываетесь полностью заблокированы.
Когда у вас настроено несколько моделей, ключевой навык — понимать, какую из них уместно задействовать в конкретной ситуации:
- Дешёвая и быстрая модель — для исследования в режиме Plan и несложных правок.
- Более мощная модель — для режима Build, когда задача отличается реальной сложностью или несёт ощутимые риски.
- Локальная модель через Ollama — если вы хотите свести дополнительные расходы к нулю либо работаете с конфиденциальным кодом, который не должен покидать вашу машину.
Удобно представлять выбор модели как выбор рецензента для pull request. Вы вряд ли поручите старшему инженеру проверку исправления опечатки, равно как не станете просить начинающего разработчика одобрять изменения в платёжной системе. Точно так же подбирайте модель под задачу и не используйте по привычке самую дорогую из настроенных, если у вас есть подходящие альтернативы в том же конфигурационном файле.
Зачем нужна избыточность: несколько провайдеров как страховка
Помимо экономии, есть ещё одна причина настраивать сразу несколько провайдеров — избыточность. Она становится критически важной, когда вы с ней реально сталкиваетесь. Сбой у провайдера, падение качества ответов или внезапное изменение условий доступа (как в случае с подписками Anthropic) могут парализовать работу.
Если у вас настроен только один провайдер, любой такой инцидент означает вынужденную паузу до решения проблемы. Конфигурация OpenCode с несколькими провайдерами позволяет быстро переключиться — например, с удалённого экземпляра Claude на локальную Llama или на другой API‑провайдер. Для этого достаточно поменять настройки, а не терять целый рабочий день.
Этап 7: автоматизируйте повторяющуюся работу с помощью пользовательских команд
Пользовательские команды в OpenCode хранятся в виде Markdown‑файлов, а имя файла напрямую определяет имя команды: например, файл test.md даёт вам команду /test. Такой подход позволяет превратить часто используемые промпты в удобные переиспользуемые инструменты.
Два ключевых синтаксических элемента делают эти команды по-настоящему динамическими, а не просто статическими шаблонами:
$ARGUMENTS— подставляет в промпт всё, что вы ввели после вызова команды.
Например, если в файлеcomponent.mdнаписано: «Создай новый React‑компонент с именем $ARGUMENTS с поддержкой TypeScript», то вызов/component Buttonавтоматически развернётся в полный, конкретный промпт про компонентButton. Это избавляет от необходимости каждый раз заново формулировать типовые задачи.!command— вставляет в промпт живой вывод shell‑команды прямо в момент запуска.
Так, команда для анализа покрытия может содержать конструкцию вроде!npm test -- --coverage, и OpenCode передаст актуальные результаты тестов модели ещё до того, как попросит её предложить улучшения. Агент получает контекст «как сейчас», а не «как было когда‑то», что сильно повышает качество рекомендаций.
На этом этапе OpenCode перестаёт быть просто чат‑интерфейсом, куда вы каждый раз вручную вводите промпты, и превращается в настроенную инфраструктуру: вы один раз описываете типовые сценарии, а затем многократно их используете.
Практические примеры и рекомендации
Стоит выделить 5–6 самых частых запросов, которые вы и ваша команда делаете регулярно, и оформить их как именованные команды. Например:
/tests <файл>— сгенерировать тесты для указанного файла;/diff-summary— резюмировать текущий diff и выделить критические изменения;/nplus1— просканировать код на N+1‑запросы и предложить варианты исправления.
Такие команды удобно хранить в общей папке (например, .opencode/commands/ в корне проекта или в глобальном конфиге) и делиться ими внутри команды. Это не только экономит время, но и стандартизирует подходы: все используют одни и те же проверенные формулировки и логику.
Этап 8: интеграция с CI/CD, таск‑трекерами и документацией
С помощью команды opencode github install можно пройти пошаговый процесс установки GitHub App и автоматической генерации файла workflow. После настройки вы сможете запускать OpenCode прямо из интерфейса GitHub: упоминание /opencode или /oc в комментарии к issue или pull request (PR) инициирует выполнение задачи в вашем собственном GitHub Actions runner‑е — с доступом к полному контексту обсуждения.
Особенно ценна эта возможность для комментариев к PR: OpenCode получает не просто текст комментария, а точный контекст — путь к файлу, номера строк и окружающий фрагмент diff. Поэтому запрос вроде «/oc добавь обработку ошибок здесь» будет обработан максимально точно: агент не будет гадать, какую часть кода нужно править, а сразу сфокусируется на нужной области.
Варианты автоматизации в CI/CD
Помимо ручного запуска по комментариям, OpenCode поддерживает несколько сценариев автоматической интеграции:
- Автоматическая проверка PR при каждом событии
openedилиsynchronize. По умолчанию выполняется полная проверка, если в конфигурации не задан конкретный промпт. Это позволяет встраивать ревью агентом в стандартный процесс код‑ревью. - Запланированные задачи через cron‑триггер. Подходит для регулярных задач поддержки — например, еженедельной проверки устаревших зависимостей, актуализации документации или поиска потенциальных уязвимостей.
Важные нюансы с разрешениями
Есть деталь, которая часто вызывает путаницу: workflow, запускаемые по расписанию, выполняются без пользовательского контекста, поэтому они не могут полагаться на унаследованные права или сессии пользователя. Если вы хотите, чтобы OpenCode по расписанию создавал ветки или открывал PR, в самом файле workflow нужно явно указать необходимые разрешения:
permissions:
  contents: write
  pull-requests: write
Без этих строк действия, требующие записи, будут заблокированы, даже если у пользователя или GitHub App такие права есть.
Пример workflow для автоматического ревью PR
Файл .github/workflows/opencode-review.yml:
name: OpenCode PR Review

on:
  pull_request:
    types: [opened, synchronize]

permissions:
  contents: write
  pull-requests: write

jobs:
  review:
    runs-on: ubuntu-latest
    steps:
      - uses: anomalyco/opencode-action@v1
Этап 9: изучите, как фреймворки агентов реализуют планирование и использование инструментов
Этот этап сознательно выводит вас за пределы непосредственной работы с OpenCode. Знакомство с тем, как устроены популярные фреймворки для построения агентных систем (например, LangGraph и OpenAI Agents SDK), меняет подход к созданию пользовательских агентов и команд внутри OpenCode: агент перестаёт быть «чёрным ящиком», а становится понятной, контролируемой системой.
Как устроено планирование в ключевых фреймворках
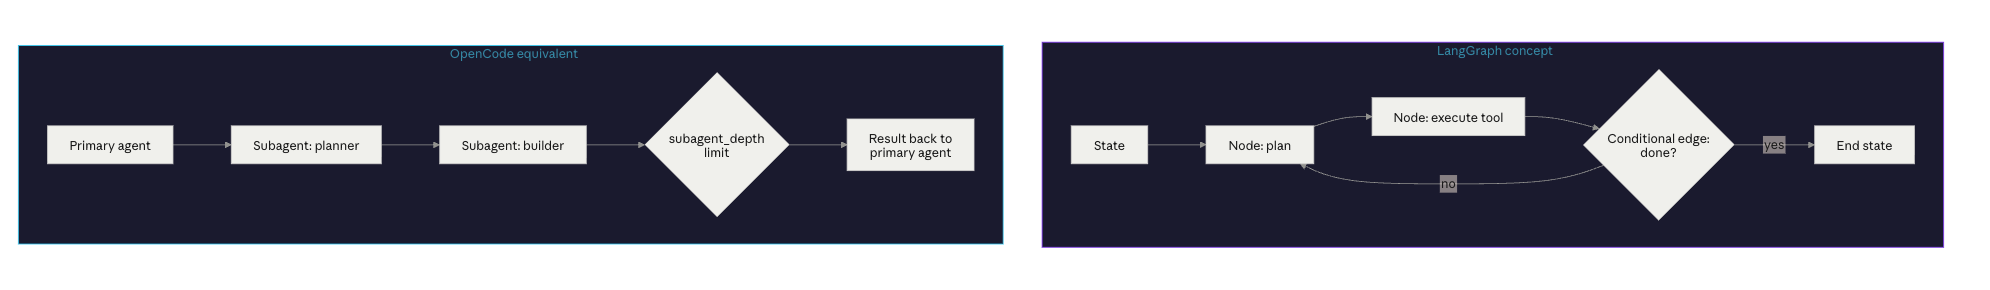
- LangGraph моделирует агента как явный граф узлов и рёбер. Состояние передаётся и трансформируется на каждом шаге, а логика выполнения — это не просто последовательность промптов, а чётко заданные переходы. Такой подход позволяет визуализировать и отлаживать многошаговые и условно‑ветвящиеся процессы: вы буквально видите, при каком условии поток пойдёт по одной ветке, а при каком — по другой.
- OpenAI Agents SDK делает ставку на простоту и быструю сборку. Здесь основной акцент — на передаче задач между специализированными агентами и на структурированных определениях инструментов. Это удобно для сценариев, где важнее скорость разработки и понятная специализация ролей, а не детальный контроль каждого шага.Эти фреймворки не запускаются напрямую внутри OpenCode, но их концепции напрямую перекликаются с архитектурой самого OpenCode — особенно с его поддержкой основных агентов и субагентов (дочерних агентов).
Что из этого полезно перенести в практику работы с OpenCode
Понимание этих подходов помогает писать более строгие и предсказуемые конфигурации:
- Явное состояние и передача контекста. В LangGraph вы вынуждены явно определять, что передаётся из одного узла в другой и при каком условии происходит переход. В терминах OpenCode это соответствует тому, как вы формулируете промпт для субагента и что именно «подтягиваете» в контекст. Чем чётче вы задаёте, какие артефакты (diff, результаты тестов, логи) передаются дальше, тем меньше агент будет «додумывать».
- Ограниченный доступ к инструментам. И LangGraph, и OpenAI Agents SDK позволяют жёстко ограничивать, какие инструменты доступны на каждом шаге. В OpenCode это реализуется через конфигурацию permission (edit, bash и т.д.) и гранулярные настройки для каждого агента. Такой контроль особенно важен в средах с повышенными требованиями к безопасности или в контейнеризированных окружениях.
- Условная логика и критерии остановки. В графовых системах вы явно задаёте условия перехода и критерии завершения. В OpenCode аналогом служит настройка глубины субагентов (subagent_depth) и логика промптов: вы можете задать субагенту условие «остановись, если не нашёл подходящий файл в трёх директориях» или «верни список кандидатов, но не применяй изменения».
Практический пример связи концепций
Условное ребро в LangGraph (например, «если тесты упали — запусти режим диагностики, иначе — продолжи рефакторинг») концептуально соответствует тому, как в OpenCode вы можете построить двухшаговый процесс:
- Субагент в режиме «только чтение + запуск тестов» проверяет статус.
- В зависимости от результата основной агент либо применяет правки, либо запрашивает дополнительную диагностику.
Разница лишь в том, что в LangGraph это рисуется как граф, а в OpenCode выражается через конфигурацию агентов и промпты. Когда вы понимаете, почему LangGraph требует явно описывать переходы, вы начинаете задавать те же вопросы и в OpenCode: «Что именно передаётся следующему шагу? При каком условии мы должны остановиться? Какие инструменты действительно нужны на этом этапе?»
Этап 10: создавайте собственные инструменты и интеграции.
Заключительный этап — разработка пользовательских MCP‑инструментов, которые расширяют возможности OpenCode за пределы локальной файловой системы и оболочки, позволяя агенту взаимодействовать с реальной инфраструктурой вашей организации.
Что такое MCP и как его использовать
MCP (Model Context Protocol) — это стандартный протокол подключения агента к внешним системам. Инструменты на базе MCP размещаются в ~/.config/opencode/tool/ (или в проектном эквиваленте) и регистрируются в opencode.json, чтобы агенты могли их обнаруживать автоматически, без ручной настройки для каждой сессии.
С помощью пользовательского MCP‑инструмента агент может:
- опрашивать внутреннюю панель деплоя;
- извлекать детали тикета из API таск‑трекера;
- проверять состояние флагов функций перед принятием решения;
- получать метаданные релизов, статусы сред или данные мониторинга.
MCP против «простых» пользовательских инструментов
Важно различать два типа расширений:
- MCP‑инструменты — реализованы по стандарту, поэтому работают не только в OpenCode, но и в других MCP‑совместимых клиентах (например, Claude Code). Если есть хотя бы небольшая вероятность, что инструмент понадобится за пределами OpenCode, стоит потратить время на соответствие стандарту MCP.
- Простые пользовательские инструменты — привязаны конкретно к конфигурации OpenCode и не переносятся автоматически в другие среды.
Стандартность MCP даёт долгосрочную гибкость: один раз написанный инструмент становится частью общей экосистемы агентных систем, а не изолированным скриптом.
Субагенты и архитектура «внутренней платформы»
На этом этапе субагенты и пользовательские инструменты объединяются в архитектуру, которая уже ближе к небольшой внутренней платформе, чем к единому ассистенту для разработки.
Одна из проверенных структур конфигурации — разделение ролей между субагентами:
- субагент анализа — только чтение, сбор контекста;
- субагент сборки — доступ к инструментам сборки, но без прав на изменение продакшн‑конфигураций;
- субагент проверки — запуск линтеров, статического анализа;
- субагент тестирования — запуск тестов, проверка покрытия, отчёты.
Координирует их основной агент, делегируя задачи по мере необходимости.
Контроль глубины делегирования: subagent_depth
По умолчанию параметр subagent_depth установлен в 1. Это означает, что основной агент может запускать субагентов, но эти субагенты не могут инициировать дальнейшие уровни делегирования.
Это не ограничение, а осознанный компромисс:
- при неограниченной глубине ошибки могут «накапливаться» в длинной цепочке вызовов, оставаясь незамеченными до момента серьёзного сбоя;
- глубина 1 делает каждое делегирование прозрачным и аудируемым: вы всегда можете отследить, какой агент принял решение и на каком основании.
Увеличивайте лимит явно и только тогда, когда архитектура действительно требует более глубоких цепочек. При этом вы сознательно снижаете прозрачность и усложняете аудит.
Безопасность и минимизация привилегий
Когда пользовательский инструмент получает доступ к реальной инфраструктуре (деплой‑системам, внутренним API, данным клиентов), к нему в полной мере применяются риски, описанные в OWASP Top 10 for Agentic Applications. Особенно актуальны две категории:
- неправильное использование инструментов — агент может вызвать инструмент с некорректными параметрами;
- злоупотребление идентификацией и привилегиями — если инструмент работает под учётной записью с широкими правами, последствия ошибки могут быть критичными.
Поэтому применяйте принцип наименьших привилегий:
- давайте инструменту ровно столько доступа, сколько необходимо для решения конкретной задачи;
- разделяйте роли: один инструмент — для чтения статуса, другой — для запуска деплоя, и никогда не совмещайте эти действия в одном компоненте без жёстких проверок;
- используйте отдельные учётные данные или временные токены с ограниченным сроком жизни и областью действия.
Этот же подход работает и для субагентов: если субагент‑рецензент имеет edit: deny, то и пользовательский инструмент, который лишь собирает отчёт о состоянии, не должен иметь прав на внесение изменений.
Распространённые проблемы, о которых полезно знать заранее
Эти ошибки встречаются настолько часто, что лучше учесть их ещё до старта, а не разбираться с ними в разгар работы.
Обнаружение контекста (Этап 3): «общие советы» вместо конкретных правил
Частая ошибка — писать в AGENTS.md общие рекомендации вроде «пиши чистый код» или «следуй стилю проекта». Модель и так ориентируется в базовых практиках, а такие фразы просто тратят контекст без реального эффекта на поведение агента.
Что действительно меняет работу агента — это скучные, но критически важные конкретики:
- Запрещённые для редактирования директории. Например: «Никогда не трогай
/generatedи/vendor: это автогенерируемые папки, правки будут перезаписаны при следующем билде». - Реальная команда тестов. Не то, что написано в README «для примера», а именно то, что реально запускается в CI:
pnpm test --coverageвместоnpm test. - Закреплённые зависимости и причины. Если какая‑то библиотека зафиксирована на конкретной версии не случайно, это нужно явно указать: «Не обновляй
legacy-libвыше версии 2.x: новый API несовместим с нашей кодовой базой».
Практический совет: в AGENTS.md лучше иметь 5 коротких, предельно конкретных правил, чем страницу общих рекомендаций. Одно правило «не редактируй /generated» спасает больше сессий, чем абзац про «чистый код».
Конфигурация нескольких моделей (Этап 6): второй провайдер «для галочки»
Типичная ситуация: во время демо или туториала подключают второго провайдера, прописывают его в конфиге, а дальше продолжают работать только с первой моделью, потому что Build по умолчанию использует именно её. В итоге второй провайдер существует формально, а выгоды от гибкости и избыточности не получается.
Как избежать:
- Сразу встройте второго провайдера в реальную ротацию. Самый безопасный и дешёвый вариант — назначить его на режим
Plan: цена ошибки здесь ниже, а польза от разнообразия моделей уже есть. - Пример: пусть
Planработает на более лёгкой и быстрой модели, аBuild— на более мощной. Это сразу даёт и экономию, и отказоустойчивость. - Регулярно проверяйте, действительно ли используются все настроенные провайдеры, а не лежат «про запас».
Интеграция с CI (Этап 8): «ничего не меняется», хотя workflow «успешен»
Самая частая жалоба при работе с GitHub Actions: workflow завершается со статусом «успешно», но в репозитории нет ни новых веток, ни PR, ни правок. Чаще всего причина проста — в YAML‑файле не прописаны явные разрешения contents: write и pull-requests: write.
Важно помнить:
- Запланированные (cron) и автоматические workflow запускаются без пользовательского контекста, поэтому они не наследуют права пользователя или GitHub App.
- Без этих разрешений любые действия, требующие записи (создание веток, открытие PR, коммиты), будут по умолчанию заблокированы. Статус «успешно» при этом может сохраняться, потому что сам workflow выполнился, просто все операции записи были отклонены на уровне API.
Чек‑лист для проверки:
- Есть ли блок
permissionsв корне workflow? - Указаны ли явно
contents: writeиpull-requests: write, если OpenCode должен что‑то создавать или менять? - Проверены ли права токена/GitHub App, который используется в шаге
anomalyco/opencode-action@v1?
Пользовательские инструменты и субагенты (Этап 10): «почему третий уровень не запускается?»
При проектировании сложных цепочек делегирования (планировщик → строитель → тестировщик) часто возникает недоумение: третий уровень просто не запускается. Причина — значение по умолчанию subagent_depth: 1.
Это не баг, а намеренное ограничение:
- При
subagent_depth = 1основной агент может запускать субагентов, но эти субагенты не могут запускать дальнейших субагентов. - Это сделано для прозрачности и аудита: любая ошибка остаётся в пределах одного уровня делегирования и легко отслеживается.
- Если вы увеличиваете глубину, вы сознательно жертвуете простотой аудита ради более сложной логики.
Когда и как увеличивать subagent_depth:
- Делайте это осознанно и только если архитектура действительно требует многоуровневого делегирования.
- Чётко документируйте, зачем нужна глубина больше 1 и какие риски вы при этом принимаете.
- Для большинства сценариев достаточно одного уровня субагентов плюс чёткое разделение ролей (анализ, сборка, проверка, тестирование) с узкими разрешениями.
Часто задаваемые вопросы
Нужно ли проходить все 10 этапов строго по порядку?
Для этапов 1–6 — да, лучше по порядку. Они закладывают фундамент:
- без понимания CLI и Git‑процесса (этапы 1 и 4) вы не сможете надёжно контролировать изменения;
- без правильной работы с промптами (этап 2) агент будет выдавать «красивые, но не те» результаты;
- без корректного контекста (этап 3) даже хороший промпт будет работать хуже;
- без владения инструментами и моделями (этапы 5 и 6) вы не сможете масштабировать использование агента.
Этапы 7–8 уже дают ощутимую отдачу, когда база есть: они про повторяемость и автоматизацию, а не про базовое понимание.
Этапы 9–10 — это уже «продвинутая архитектура». Их можно изучать параллельно или выборочно: например, сразу сделать простой MCP‑инструмент под свою задачу, не разбирая LangGraph. Знание фреймворков позже поможет улучшить дизайн, но не является обязательным условием для старта.
OpenCode vs Claude Code: чем они реально отличаются сейчас
После блокировки подписок Claude Pro/Max в сторонних инструментах разница стала ещё чётче:
| Критерий | OpenCode | Claude Code |
|---|---|---|
| Провайдеры | >75 провайдеров + локальные модели (Ollama и др.) | Привязан к Anthropic (Claude) |
| Гибкость и отказоустойчивость | Можно быстро переключиться между провайдерами, настроить разные модели под разные задачи, использовать локально | Зависимость от одного вендора |
| Интеграция инструментов | MCP, глубокая настройка прав, субагенты, конфигурация на уровне проекта и глобально | Фокус на «встроенном» опыте Claude с ограниченным набором расширений |
| Сценарий офлайн/в изолированной среде | Возможен через локальные модели; LSP, редактирование, shell работают как обычно | Оффлайн‑режим и изоляция сильно ограничены |
То есть ключевое отличие — не «дешевле Claude», а архитектурная независимость: вы сами выбираете, где и как выполняется модель, и можете менять это без переписывания всей инфраструктуры.
Можно ли использовать OpenCode полностью офлайн?
Да, при условии, что модель запускается локально:
- через Ollama;
- либо любой локальный OpenAI‑совместимый эндпоинт.
При этом:
- LSP, редактирование файлов и shell‑доступ работают так же, как и раньше;
- «за пределы машины» уходит только запрос к модели — а если модель локальная, то и этого нет.
Это особенно удобно для чувствительных проектов, работы в изолированных средах или при нестабильном интернете.
Сколько из этого нужно одиночному разработчику, а сколько — команде?
- Этапы 1–6 полезны всем: и одиночкам, и командам. Это базовый набор навыков, который делает работу с агентом предсказуемой и эффективной.
- Этапы 7–8 (пользовательские команды, CI‑интеграция) быстрее окупаются в команде: общие команды и автоматические проверки экономят время сразу нескольким людям. Но и одиночный разработчик выигрывает, если у него есть повторяющиеся сценарии (например, «сгенерировать тесты», «проверить покрытие», «обновить зависимости»).
- Этапы 9–10 чаще оправдывают вложения в командном масштабе: там речь идёт о создании внутренней платформы, интеграции с корпоративными системами, сложной оркестрации. Но ничто не мешает одиночке сделать 1–2 узкоспециализированных MCP‑инструмента или простую архитектуру субагентов под свой рабочий процесс.